Natera用Bedrock AgentCore实现100%准确语音预约|AI落地与Agent
有人把整套报关流程交给了Agent,人只签字;今天这家医疗公司更狠——让AI语音Agent全权处理患者上门采血预约,连认证、延迟、工具调用都稳如磐石。
▍今日主打
Amazon Bedrock AgentCore推出跨账号知识库连接能力
Natera 是美国领先的基因检测与临床实验室服务提供商,其移动采血(mobile phlebotomy)业务需高频对接患者,安排护士上门抽血。传统方式依赖人工电话调度+多系统手动录入,平均响应超2分钟、错误率高、夜间/节假日覆盖差。这次他们基于 Amazon Bedrock AgentCore 构建了端到端语音Agent:患者拨打400电话后,由语音Agent实时对话理解意图(如‘下周三上午想抽血’‘地址在朝阳区望京SOHO’),自动完成地址校验、护士排班查询、日历锁定、短信确认,并全程保持自然对话流。
对想落地AI自动化的企业来说,这不是概念Demo——它直击三个最痛的工程现实:一是‘双WebSocket桥接’设计,让语音流(Telephony)与Agent推理流完全解耦,避免ASR/TTS卡顿拖垮Agent状态机;二是‘事件驱动延迟掩蔽’,在调用外部系统(如HR排班API)时,用预设话术(‘我正在为您匹配最近的护士…’)维持对话感,实测端到端延迟压到6.8秒;三是‘渐进式信任认证’,不强求首次通话就获取身份证号,而是分三步:先用手机号+姓名初筛→预约成功后发短信二次验证→采血当天护士APP扫码终验,既保合规又提转化。这比堆参数、炫多模态更值得抄作业。
我们认为,该案例是当前医疗SaaS领域Agent落地的黄金标尺:它没碰诊断、不开药方,专注在‘非临床但高摩擦’的运营环节——预约、调度、确认。小团队可直接复用其架构模式:语音入口 + AgentCore + 现有CRM/排班系统API。唯一前提是你得有结构化可用的排班数据源。别一上来就想做‘全科AI医生’,先把挂号台搬上云。
—— 以下是今天的全部 15 条速览 ——
Agent 与流程自动化
1. Amazon Bedrock AgentCore推出跨账号知识库连接能力
Bedrock AgentCore现在支持Agent运行在A账号,却能安全调用B账号中Redshift Serverless支撑的知识库,无需复制或导出原始数据。
核心是通过IAM角色委托+VPC Endpoint策略+AgentCore内置的跨账户凭证代理机制实现零数据迁移。
AWS提供了两种集成路径:代码型(用Strands SDK自定义Agent逻辑)和声明型(纯YAML配置AgentCore Harness)。
号哥说:这对集团型企业意义重大——财务、法务、HR等敏感部门知识库可物理隔离在独立账号,业务线Agent却能按需调用。它绕开了传统RAG中‘知识同步延迟’和‘权限穿透风险’两大死结,是企业级Agent架构走向生产就绪的关键一步。
落地提点:如果你公司已用AWS多账号管理,今天起所有新Agent项目都该默认启用跨账号知识库,别再为‘数据孤岛’妥协做本地embedding。
AWS Machine Learning Blog · 阅读原文
2. AWS发布AgentCore通用评估框架:支持LangGraph、LlamaIndex等任意框架
Amazon Bedrock AgentCore Evaluations是一个框架无关的Agent评测服务,只要Agent输出OpenTelemetry标准遥测,就能被自动打分。
目前已验证兼容LangGraph、LlamaIndex、OpenAI Agents SDK、Google ADK、Claude Agent SDK、Strands Agents等主流框架。
评测维度包括任务完成率、工具调用准确率、响应延迟、幻觉率,并支持自定义评分权重。
号哥说:过去企业选Agent框架常陷‘框架绑定焦虑’:怕投入半年后发现评测体系不通用、难横向对比。这个服务把评估层抽离出来,相当于给Agent装上了‘通用仪表盘’——你用什么轮子不重要,跑得多快多稳我们统一量。
落地提点:团队在选型LangChain还是LangGraph前,先用AgentCore Evaluations跑个baseline测试,5分钟看出谁更适合你的业务链路。
AWS Machine Learning Blog · 阅读原文
3. IBM开源Granite 4.2系列:3B/8B/30B模型原生支持Agentic RL与工具调用
IBM发布Granite 4.2全系模型(3B/8B/30B),全部Apache 2.0开源,上下文窗口达512K token。
8B与30B版本内置‘Agentic RL模块’,可在沙箱环境中自主执行代码、终端命令、网络搜索,且训练过程使用真实工具API反馈。
每个模型提供‘思考/低努力/非思考’三档开关,企业可根据场景动态调节推理开销与响应速度。
号哥说:这是首个将‘Agentic RL’(智能体强化学习)作为出厂能力嵌入开源基座模型的实践。不同于微调后加插件,它让模型天生懂‘什么时候该查数据库、什么时候该写脚本’,大幅降低构建复杂Agent的门槛。尤其适合需要自主运维、IT支持类Agent的中型企业。
落地提点:想快速搭建内部IT助手?直接拉取Granite 4.2-8B + 自建Terminal API,比从头训一个Qwen小模型省3个月。
The Decoder · 阅读原文
4. Particle Radar平台让13万播客可被AI Agent搜索与调用
Particle推出Radar平台,已分析超13万个播客,生成结构化摘要、时间戳语义索引及主题图谱。
所有内容通过MCP(Model Context Protocol)协议暴露为标准API,AI Agent可像调用数据库一样发起‘查找2025年关于供应链韧性的专家访谈’。
平台支持开发者用自然语言定义‘播客知识源’,并自动映射到对应音频片段与文字稿。
号哥说:播客长期是AI知识盲区——语音难转写、内容无结构、更新不可控。Radar不仅解决了技术问题,更定义了一种新范式:把非结构化长尾媒体变成Agent可编程的‘活知识源’。对咨询、教育、市场团队极具价值。
落地提点:市场部同事明天就能用Radar API搭个Agent,自动抓取竞品CEO最新播客观点,生成周报摘要——不用等工程师排期。
TechCrunch AI · 阅读原文
5. Arga Labs获1000万美元种子轮融资,专注企业级AI Agent训练平台

Arga Labs宣布完成1000万美元种子轮融资,由General Catalyst领投,Box Group、Emergence等跟投。
其平台聚焦解决企业Agent落地最大瓶颈:如何用私有业务数据(如客服对话、合同文本、ERP日志)高效训练出高准确率、低幻觉的Agent。
核心能力包括‘任务感知数据合成’(自动构造带真实约束的SFT样本)和‘多跳推理链标注器’(可视化标注Agent决策路径)。
号哥说:融资本身不稀奇,关键是Arga直击企业痛点:不是缺模型,而是缺‘能让模型听懂销售话术、财务规则、法务条款’的训练方法。它把Agent训练从‘调参艺术’变成‘可度量工程’,适合已有大量业务文档但苦于无法注入Agent的中大型公司。
落地提点:如果你的Agent总在合同条款上犯错,别急着换大模型——先试试Arga的数据合成工具,成本可能不到重训一次Qwen的1/10。
TechCrunch AI · 阅读原文
AI 工具 · 实测上新
1. Amazon SageMaker SDK v3重构Script Mode:本地代码实时热加载进容器
SageMaker Python SDK v3彻底重写Script Mode,引入ModelTrainer与ModelBuilder统一接口,屏蔽底层容器细节。
新机制支持SourceCode实时同步:修改本地.py文件后,Agent无需重建Docker镜像,即可在GPU容器内立即生效,迭代速度提升5倍以上。
官方示例涵盖scikit-learn随机森林与Stable Diffusion 3.5 LoRA多卡微调,证明其对传统ML与生成式AI均适用。
号哥说:这是AI工程师最渴求的‘开发体验升级’:告别‘改一行代码→build→push→deploy→wait’的痛苦循环。尤其对需要频繁调试Agent工具函数(如报销OCR、合同解析)的团队,热加载意味着一天能跑20版逻辑而非2版。
落地提点:正在用SageMaker部署Agent工具函数?立刻升级SDK v3,热加载能让你的调试效率翻倍,比换显卡实在。
AWS Machine Learning Blog · 阅读原文
2. Google Gemini 3.5 Transcribe上线:支持85+语言+专业术语自动识别

Gemini 3.5 Transcribe是Gemini家族新成员,专攻高精度语音转写,支持超85种语言及方言。
能自动识别医疗、法律、金融等垂直领域术语(如‘PD-L1表达水平’‘背对背条款’),错误率比上代降低37%。
提供API与Web控制台双入口,转写结果自带时间戳、说话人分离、关键词高亮,并可一键生成摘要。
号哥说:语音转写早已不是‘能转就行’,而是‘转得准、懂行话、能联动’。Gemini 3.5 Transcribe的行业术语识别能力,让它成为客服质检、医患沟通记录、法务会议纪要等场景的即插即用工具,无需定制ASR模型。
落地提点:做客服质检的团队,今天就能用Gemini 3.5 Transcribe API接入现有工单系统,自动生成‘客户情绪+关键诉求+处理建议’三段式报告。
Google DeepMind Blog · 阅读原文
3. Liquid AI开源Pipette:首套面向边缘设备的AI模型联合评测平台
Pipette是Liquid AI开源的基准测试套件,专为手机、IoT设备等边缘硬件设计,同时评测模型精度、量化效果、运行时性能与芯片适配性。
它不依赖服务器级FP16精度报告,而是实测INT4量化后在骁龙8 Gen3上的吞吐与功耗,给出真实‘能用指数’。
平台已集成12款主流轻量模型(Phi-3、Gemma-2B、TinyLlama等),并开放厂商合作接入自有芯片。
号哥说:大模型上云是常态,但Agent要真落地,必须能跑在员工手机、工厂PLC、车载中控里。Pipette填补了‘云侧benchmark’与‘端侧真实体验’之间的鸿沟,让企业采购边缘AI方案时,终于有了可验证的客观标尺。
落地提点:计划在销售APP里嵌入本地Agent?别只看paper指标——用Pipette跑一遍你的目标机型,5分钟看清它到底能不能扛住连续语音交互。
MarkTechPost · 阅读原文
4. Tailcat:类netcat但走Tailscale数据平面的轻量网络调试工具
Tailcat是Tailscale新推的命令行工具,功能类似netcat,但所有流量经Tailscale加密隧道传输,无需公网IP或端口转发。
支持TCP/UDP连接、端口扫描、HTTP请求、TLS握手测试,且自动继承Tailscale设备身份与ACL策略。
特别适合调试Agent与本地开发服务(如FastAPI工具后端)的安全连通性,DevOps可将其嵌入CI流水线做连通性验证。
号哥说:Agent开发常卡在‘本地工具服务怎么被云端Agent安全访问’——开防火墙不安全,配反向代理太重。Tailcat用零配置隧道解决了这个毛细血管级问题,是开发者私有Agent调试链路上的‘瑞士军刀’。
落地提点:正在本地跑一个报销OCR服务?用tailcat监听3000端口,Agent通过Tailscale域名直连,比配Nginx省20分钟。
Hacker News · 阅读原文
5. GoDaddy用Amazon Quick替代旧BI系统:年省15000小时,渲染<5秒
GoDaddy耗时两年将全部BI看板迁至Amazon Quick,覆盖财务、市场、产品等12个部门。
成果包括:看板数量减少50%,平均渲染时间压至4.2秒,100%员工获得AI自助分析权限(自然语言问数据)。
Quick深度集成Bedrock,支持用户输入‘对比Q2各渠道ROI,排除促销活动影响’,自动生成SQL+可视化。
号哥说:这不是又一个BI替换故事,而是‘AI Agent如何接管数据分析入口’的教科书案例。Quick把NL2SQL、动态过滤、归因分析封装成开箱即用能力,让业务人员自己就成了‘数据Agent’,彻底绕过分析师队列。
落地提点:如果你的报表还在等分析师手工跑,Amazon Quick就是最平滑的Agent化起点——导入数据后,销售总监明天就能用中文问‘上月流失客户都买了啥竞品?’
AWS Machine Learning Blog · 阅读原文
行业 AI 落地
1. loveholidays用OpenAI Codex让全员变开发者,需求交付提速3倍
英国旅游平台loveholidays引入OpenAI Codex,为产品、市场、客服等非技术岗位提供低代码IDE。
员工用自然语言描述需求(如‘在预订页加个天气弹窗’),Codex自动生成前端代码+调用天气API+埋点逻辑,并推送PR待审核。
上线6个月,非技术人员提交PR占比达41%,平均需求交付周期从14天缩短至4.2天。
号哥说:这打破了‘只有程序员才能改系统’的组织天花板。Codex在这里不是替代工程师,而是把业务人员的‘想法’翻译成可执行代码,让IT资源聚焦在架构与安全,而非重复造轮子。对传统行业数字化转型极具参考性。
落地提点:别再抱怨业务提需求慢——给他们Codex IDE,让产品经理自己写AB测试脚本,比开10次评审会更快。
OpenAI News · 阅读原文
2. Ex-Meta科学家创业Perceptron:视觉AI落地工厂产线质检与导航

Perceptron由前Meta计算机视觉团队核心成员创立,其视觉模型专为工业场景优化,支持弱光、反光、小样本缺陷识别。
已在汽车零部件厂部署,将漏检率从8.2%降至0.3%,并实现AGV叉车在无GPS环境下厘米级自主导航。
模型可直接接入老旧PLC设备,通过OPC UA协议读取传感器数据,形成‘视觉+IoT’闭环决策。
号哥说:制造业AI落地最难的是‘与老设备对话’。Perceptron不追求通用多模态,而是深扎工业协议与边缘部署,用实际漏检率下降8个点证明:AI不是锦上添花,而是产线生存刚需。
落地提点:工厂有质检员天天盯屏幕?先上Perceptron视觉Agent试跑一条线,两周内看到漏检率变化,再决定是否铺开。
TechCrunch AI · 阅读原文
3. ChatGPT for Teachers扩展至55个美国学区,覆盖超10万教育工作者
OpenAI将ChatGPT for Teachers正式推向55个美国公立学区,提供FEDRAMP合规部署、教师专属提示模板、课堂活动生成器。
教师可用其一键生成分层阅读材料、个性化数学题、学生行为干预方案,并自动匹配州课程标准(如CCSS、TEKS)。
试点显示,教师每周备课时间平均减少9.3小时,教案通过率(校长审批)提升至92%。
号哥说:教育行业AI落地最怕‘技术炫技脱离教学’。ChatGPT for Teachers的胜出在于:它不做AI家教,而是做‘教师生产力杠杆’——所有功能围绕‘减负、合规、易用’设计,连提示词都按学科预置好。
落地提点:学校信息主任别急着自建大模型,先申请ChatGPT for Teachers试点,90%的教案生成、学情分析需求它已能闭环。
OpenAI News · 阅读原文
4. Z.ai发布GLM-5.3-Flash:320B MoE模型,1M上下文,MIT授权

Z.ai发布GLM-5.3-Flash,总参数320B、每token激活18B的MoE(混合专家)模型,上下文窗口达1,048,576 token。
模型MIT开源,Hugging Face可直接下载权重;API定价0.15美元/百万输入token,0.50美元/百万输出token。
在终端操作(Terminal-Bench)、代码生成(DeepSWE)等Agent关键任务上,得分显著超越同规模闭源模型。
号哥说:这是中国AI力量在‘Agent原生模型’赛道的明确信号:不拼纯语言能力,而专攻Agent刚需——超长记忆、终端交互、代码执行。1M上下文让Agent能‘记住’整个企业知识库,MIT授权则扫清企业商用法律障碍。
落地提点:要做企业级Agent?别只盯着Qwen或Llama——GLM-5.3-Flash的1M上下文+MIT许可,可能是你知识库Agent最省心的基座选择。
MarkTechPost · 阅读原文
5. Alibaba Qwen3.8-Flash-Next发布:125B MoE,仅6B参数激活/Token
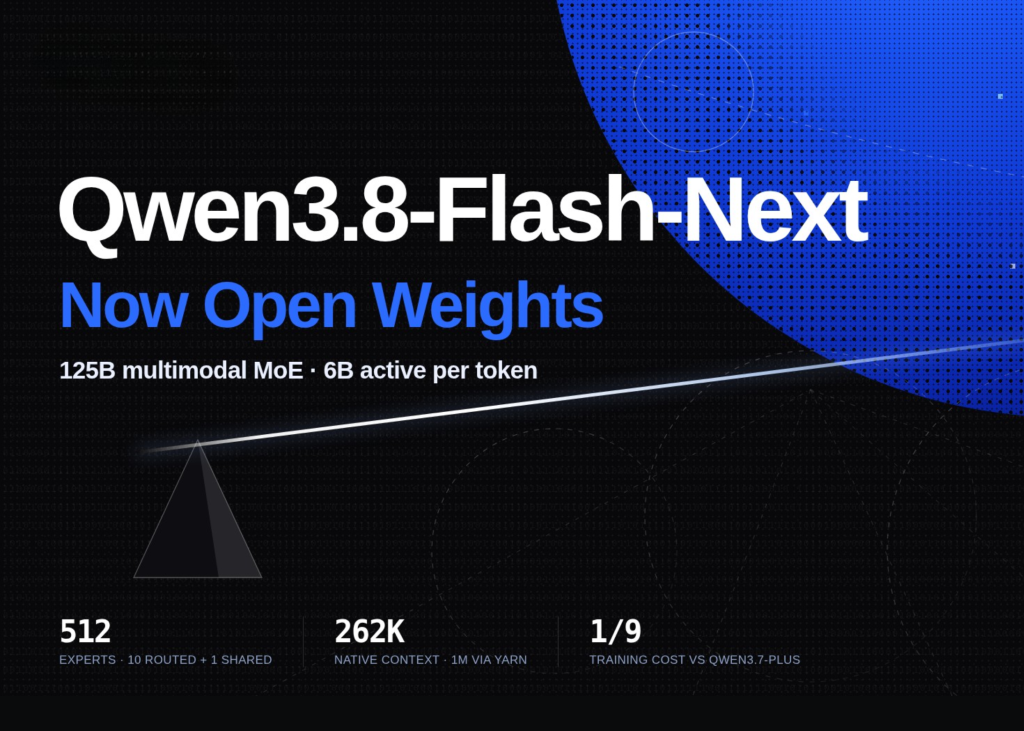
阿里Qwen团队发布Qwen3.8-Flash-Next,125B参数MoE模型,每token仅激活6B参数,主打极致推理性价比。
作为Qwen4架构预览版,它采用Gated DeltaNet与Qwen Sparse Attention等新设计,在A100上推理速度达Llama-3-70B的2.1倍。
已开源权重,支持Hugging Face Transformers与vLLM,企业可直接部署到4×A100集群。
号哥说:当行业还在卷大参数时,Qwen选择‘用更少参数干更多事’。6B/Token的激活量意味着:中小企业用现有GPU资源就能跑起接近70B能力的Agent,大幅降低Agent落地算力门槛。
落地提点:小公司想上Agent但怕GPU贵?Qwen3.8-Flash-Next在4张A100上就能跑出70B级效果,比租用云大模型省60%成本。
MarkTechPost · 阅读原文
———— 关于我们 ————
「号哥聊AI」专注 AI 落地:帮企业把重复、跨系统的流程做成 AI Agent(采购、客服、单据、报表……)。
· 想让公司某个流程自动化 —— 在本号【发消息回复「自动化」】,我们帮你看看能怎么落地;
· 想学 Agent 开发 / AI 工具 —— 关注本号,每天更新。
本文为 国外最新的AI资讯摘要与点评,非原文转载;版权归原作者所有,点击链接可读原文。
📚 往期回顾
- AWS OpenSearch MCP Apps实现Agent可观测性闭环|AI落地与Agent
- Amazon Connect Agentic Voice 实现餐厅电话点餐全自动|AI落地与Agent
- Vercel推Is Agentic:免费网站Agent就绪度评分工具|AI落地与Agent
- Munder Difflin:用AI Agent组建虚拟办公室,克隆你来处理采…|AI落地与Agent
- AWS推ADOP:用AI Agent把数据工程从周压缩到小时|AI落地与Agent
- AWS用AgentCore多智能体自动化云迁移,IaC开发从周缩至分钟|AI落地与Agent
- Fanatics用多Agent系统接管体育博彩客服|AI落地与Agent