OpenAI Astra让内部研发计划提前6个月,Agent真能拉快研发节奏|AI落地与Agent
有人把整套报关流程交给了 Agent,人只签字;今天这条更狠——AI 不再只干执行,它开始加速‘想’的过程。
▍今日主打
OpenAI工程师实测:Astra让研发计划整体提前6个月
OpenAI 工程师 Thibault Sottiaux 在内部实测中发现,Astra(GPT-6 系列中专为开发者优化的版本)将多个研究与工程任务的周期显著压缩:一个原定 Q4 启动的模型评估框架,因 Astra 自动完成实验设计、代码生成、结果分析和文档撰写,被提前至 Q2 上线;另一个涉及多模态对齐的探索性项目,从‘每周跑1轮人工调试’跃升为‘每日自动生成5组假设并验证3条’。关键不在算力堆砌,而在于 Astra 对研发工作流的深度嵌入——它理解‘什么是好实验’,能调用内部沙盒、读取未公开日志、复用历史失败 trace,并用自然语言向研究员解释每步决策依据。
这对想落地 AI 自动化的团队意味着:研发不是‘不能自动化’,而是过去缺一个真正懂科研语境的 Agent。小公司不必等大模型,可先用 Astra 类工具接管 PRD 拆解、测试用例生成、周报摘要等‘思考型重复劳动’;技术负责人要立刻盘点:你团队里哪些‘需要经验判断但模式固定’的环节,正被资深员工手动消耗?
我们判断:Astra 的价值不在单点提效,而在把‘试错成本’从 GPU 小时降为 token 成本。适合已有稳定研发流程、但卡在迭代速度上的 AI 原生团队;传统企业若想跟进,建议先从代码评审辅助或需求文档自动校验这类低风险高回报场景切入,而非一上来就让 Agent 写核心算法。
—— 以下是今天的全部 15 条速览 ——
Agent 与流程自动化
1. OpenAI工程师实测:Astra让研发计划整体提前6个月
OpenAI 开发者 Thibault Sottiaux 公开表示,内部使用 Astra(GPT-6 系列开发者专用版)后,多个研发项目的交付时间平均提前 6 个月;
Astra 不仅写代码,还能自主设计实验、分析运行结果、生成技术文档,并用自然语言向工程师解释推理链;
该能力已用于模型评估框架搭建、多模态对齐探索等真实研发场景,非概念演示。
号哥说:这是少有的、由一线开发者亲述的 Agent 加速研发的硬核案例——它证明 AI 不只是替代‘执行’,更能压缩‘思考-验证-迭代’这个最耗时的闭环。对技术负责人来说,这比省几个客服人力更具战略意义:谁先让 AI 参与研发,谁就抢下下一代产品定义权。
落地提点:别急着买大模型,先拿 Astra 类工具跑通你的周会纪要→任务拆解→PRD初稿→测试用例生成这条链,这才是研发提效的最小可行闭环。
The Decoder · 阅读原文
2. Meta FAIR推出研究偏好模型RPMs:用冻结LLM预筛15个实验,只跑最优1个
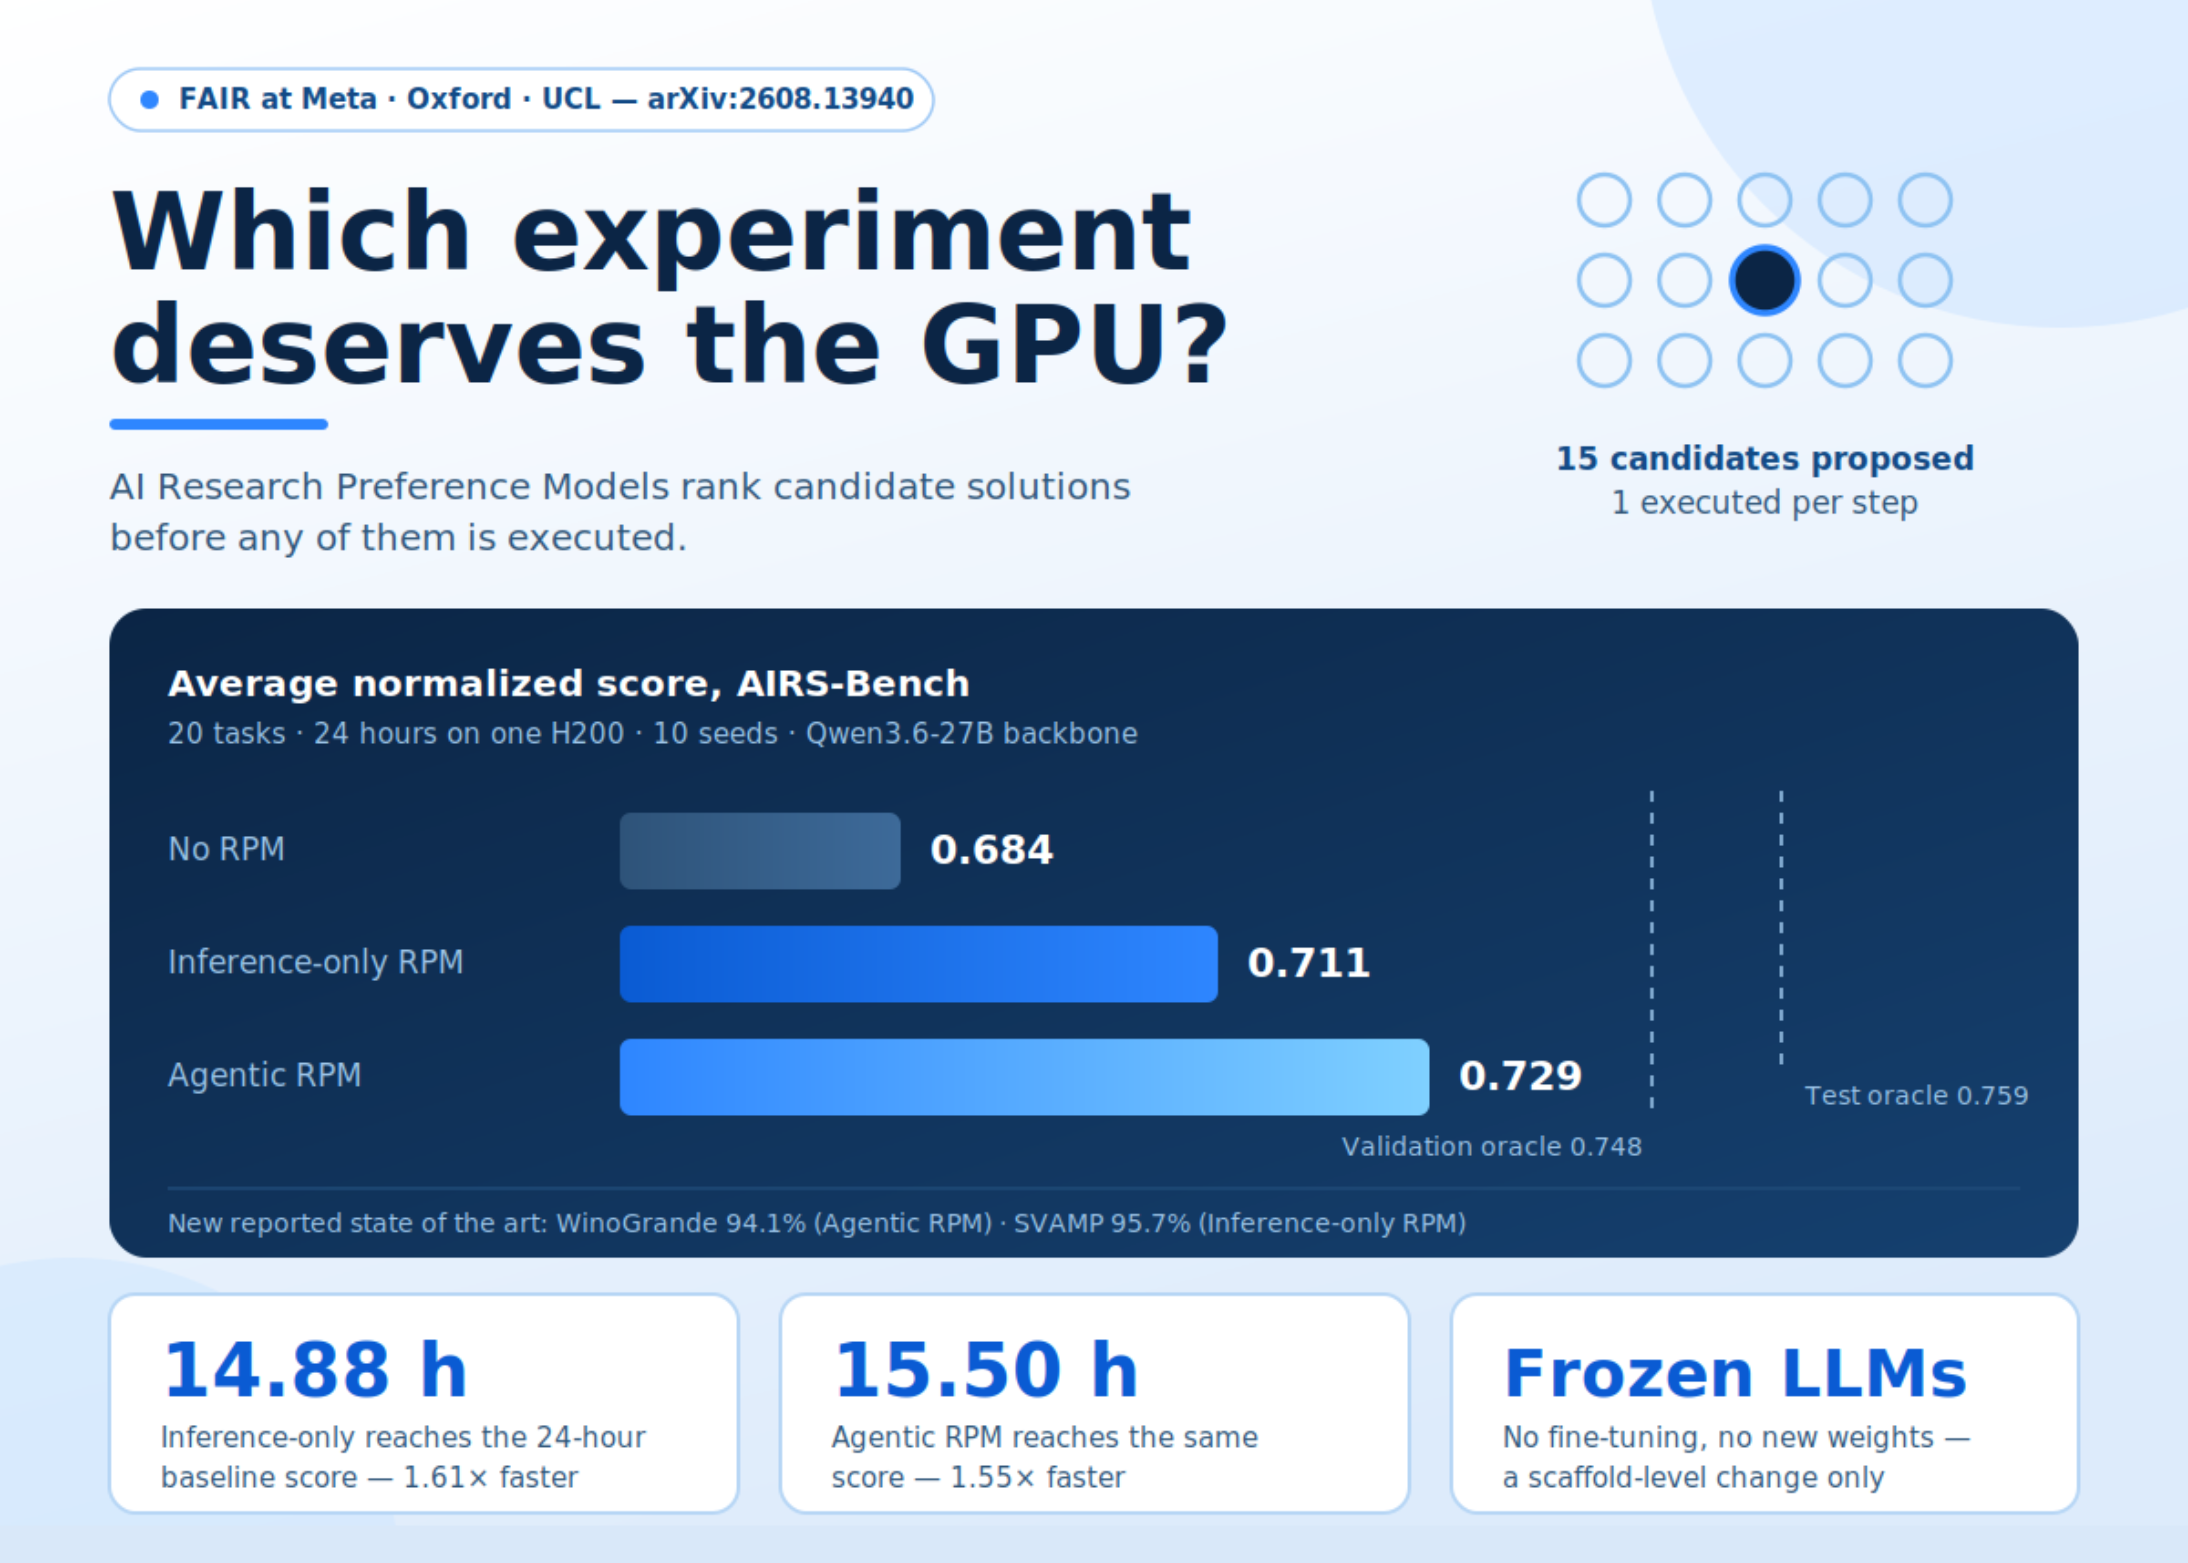
Meta FAIR 联合牛津、UCL 提出 AI Research Preference Models(RPMs),本质是轻量级、冻结权重的 LLM ‘裁判’;
RPMs 在不实际运行的情况下,对 15 个待选 ML 实验进行排序,系统仅执行排名最高的 1 个;
在 AIRS-Bench 基准上,该方法将平均归一化得分从 0.684 提升至 0.729,且 24 小时基线结果可在约 15 小时内达成。
号哥说:RPMs 把‘GPU 时间’变成可规划的资源——就像给研发装上交通灯。它不追求模型更强,而是用极低成本(冻结 LLM)过滤掉 93% 的低效尝试。对中小企业尤其友好:你不需要自研大模型,只需接入类似 RPMs 的轻量裁判模块,就能让现有训练 pipeline 效率翻倍。
落地提点:小团队做AI研发别死磕参数调优,先加个RPMs式‘实验守门员’,把GPU省下来喂真正值得跑的实验。
MarkTechPost · 阅读原文
3. UC伯克利发布CUA-Lite:统一计算机使用Agent的沙箱、数据、评测与强化学习框架
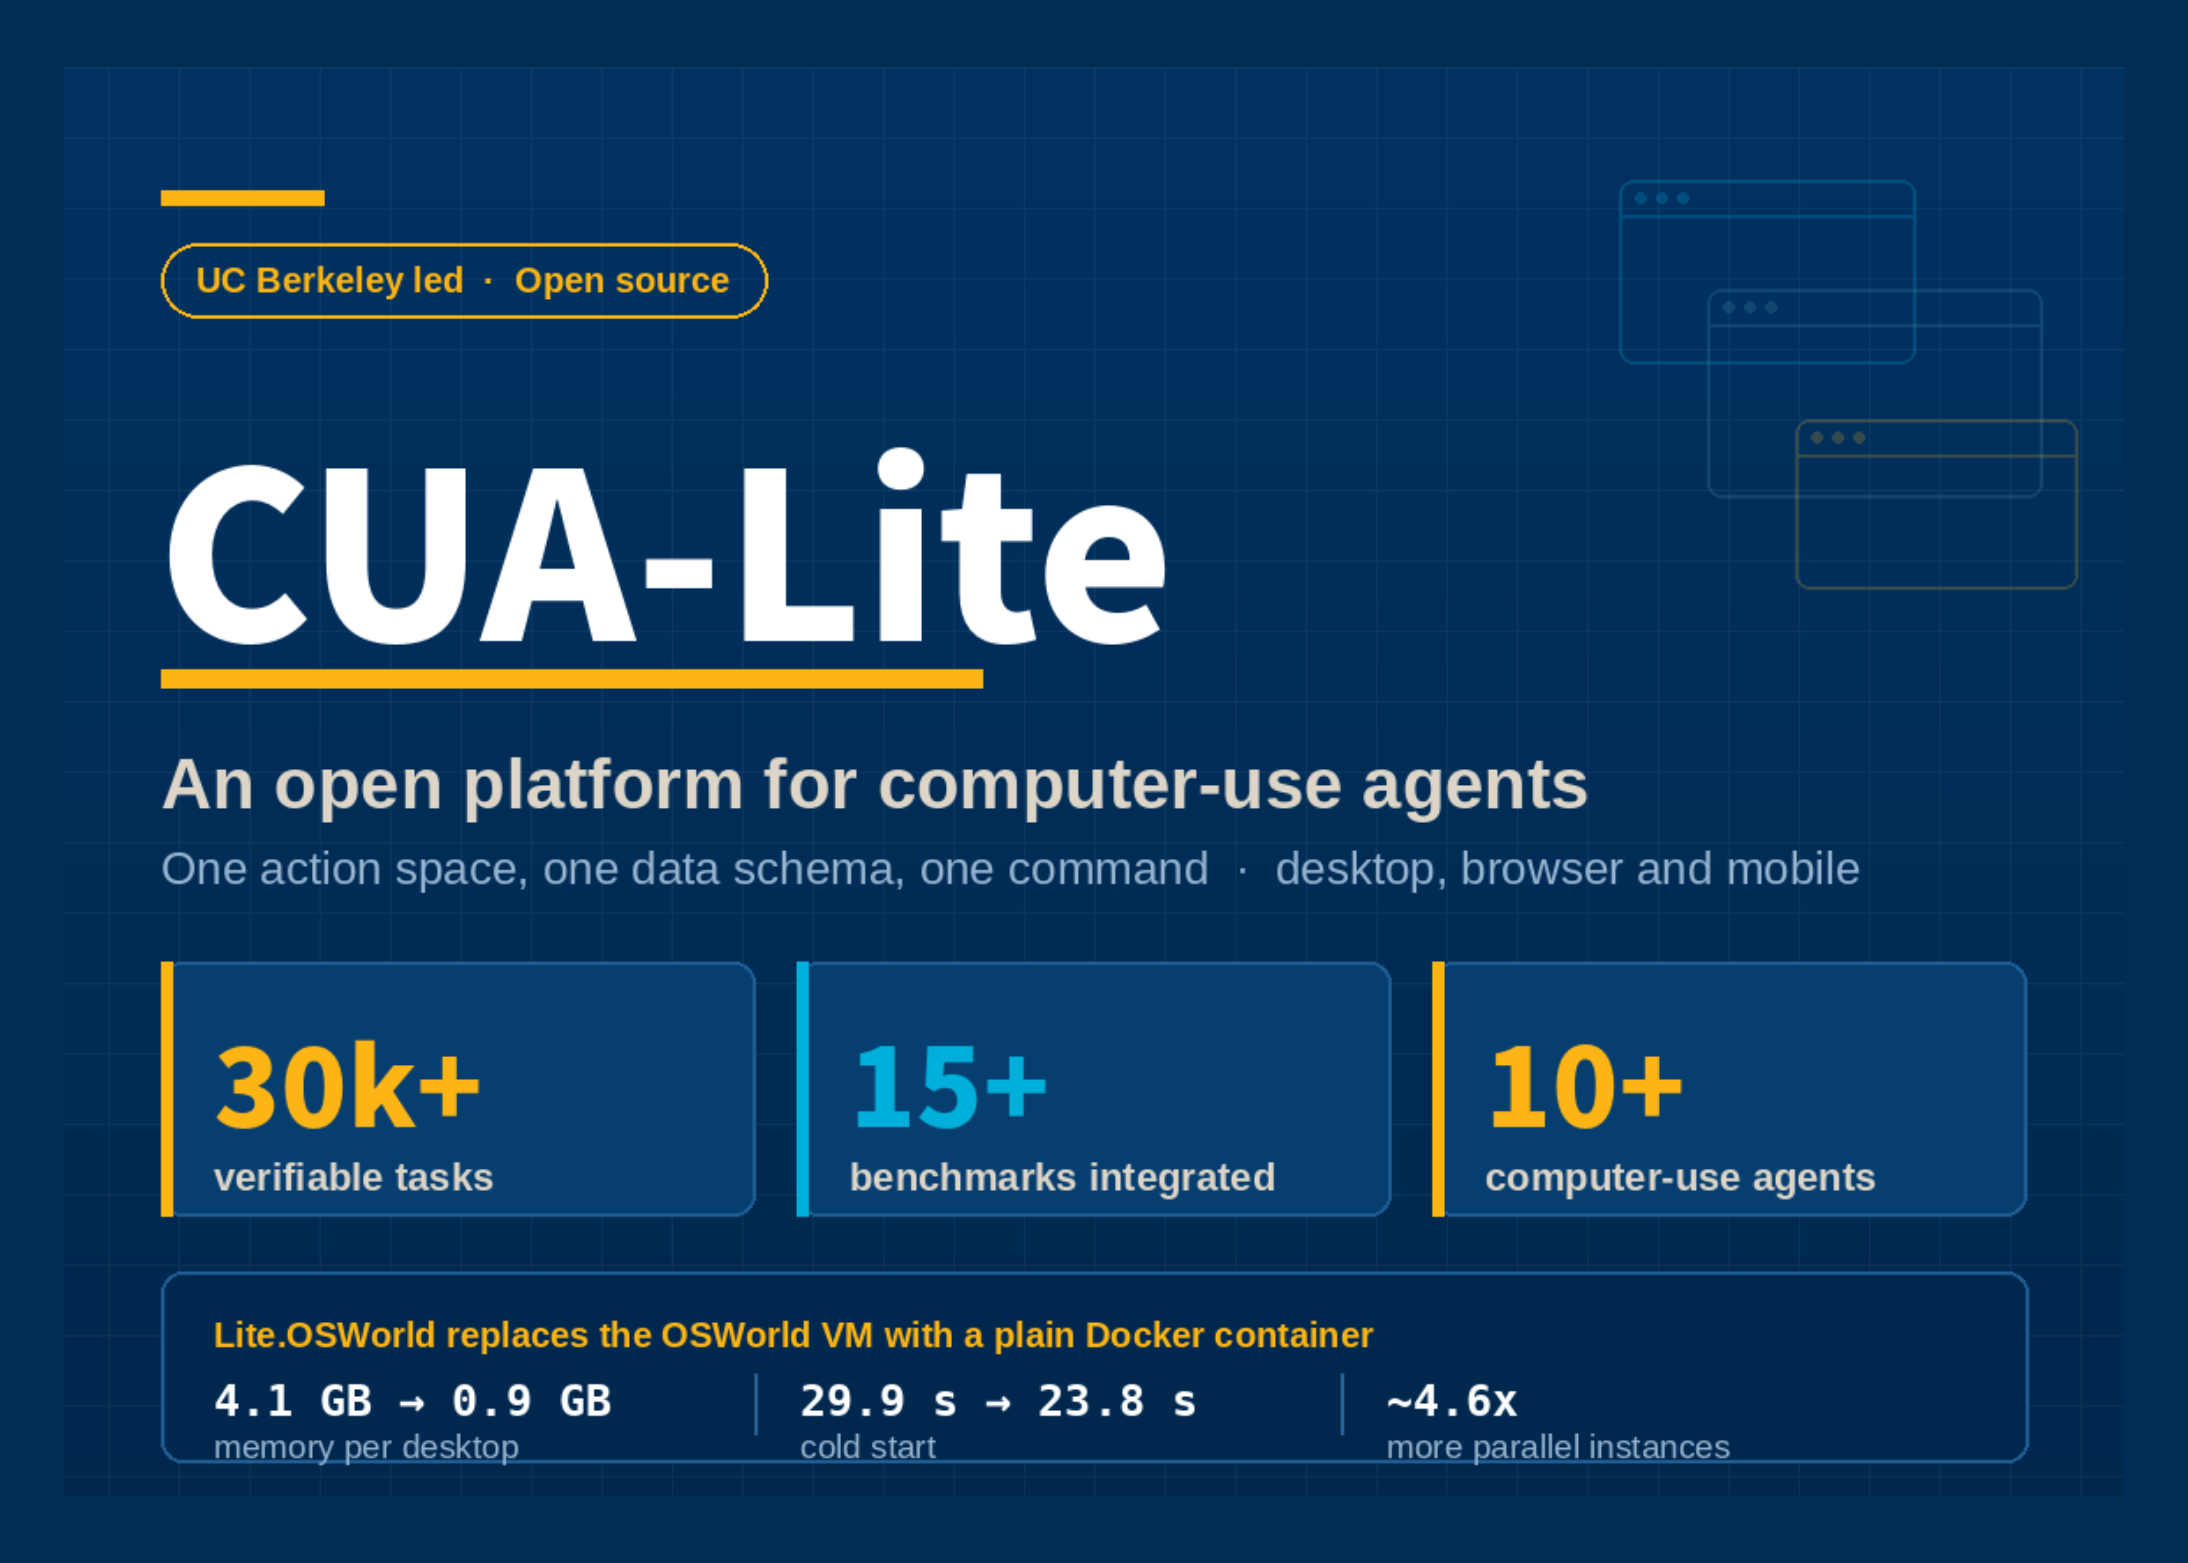
CUA-Lite 是 UC 伯克利主导的开源平台,旨在解决 Computer-Use Agent(CUA)开发中环境、数据、评估、训练四件套格式割裂的顽疾;
它用单一动作空间和统一数据 Schema 整合所有组件,并用 0.9GB 的标准 Docker 容器替代 OSWorld 的 4.1GB 虚拟机;
目标是降低 CUA 训练门槛,让研究者能像调参一样快速切换任务、重用 trace、公平比较不同 agent。
号哥说:CUA-Lite 不是又一个新模型,而是给整个 Agent 开发‘修路’——它把原本散落各处的沙箱、数据集、评测脚本打包成‘开箱即用’的标准化套件。对想学 Agent 开发的读者,这意味着你可以跳过环境配置地狱,直接从‘如何让 Agent 打开 Excel 并填表’这种真实任务入手。
落地提点:想动手写第一个Computer-Use Agent?别碰OSWorld,直接clone CUA-Lite,用它的Docker沙箱跑通‘打开浏览器→查天气→截图’三步链。
MarkTechPost · 阅读原文
4. OpenAI内部报告:编码Agent正重塑AI研究范式,实验速度与任务复杂度双升
OpenAI 发布《Research Acceleration: The View Inside OpenAI》报告,首次系统披露其内部 coding agent 使用数据;
数据显示,Agent 辅助下的实验启动时间缩短 40%,单次实验覆盖变量维度提升 2.3 倍,且 68% 的新研究方向由 Agent 提议触发;
报告强调,Agent 不是替代研究员,而是将‘重复性思考’(如参数组合枚举、错误日志归因)自动化,释放人类专注更高阶假设构建。
号哥说:这份报告的价值在于破除了‘Agent 只能干体力活’的迷思——它用真实数据证明,AI 正在参与科研中最难的部分:提出好问题。对企业技术管理者而言,这不是未来图景,而是当下可抄的作业:把你的研发知识库+内部 API 接入 Agent,让它每天生成 3 条‘可能被忽略的优化路径’。
落地提点:别让Agent只写CRUD,把它接入你的Jira和Confluence,让它每天早10点推送‘本周3个被埋没的技术债机会点’。
OpenAI News · 阅读原文
5. arXiv论文:LLMs作为认知病毒——探讨大模型如何重构人类推理习惯
这篇 arXiv 论文(2609.03344)并非技术方案,而是从认知科学角度分析 LLM 对人类思维模式的潜在影响;
作者指出,持续依赖 LLM 进行逻辑推导、论证构建甚至自我反思,可能导致人类‘元认知肌肉’萎缩,形成‘提示即答案’的思维惰性;
论文呼吁在 Agent 设计中嵌入‘认知反脆弱’机制,例如强制用户复述推理步骤、限制单次输出长度、引入不确定性提示。
号哥说:这是今日唯一入选的论文,但它对落地者极具警示价值:当你的团队越来越依赖 Agent 写周报、做决策、编文档时,是否也在悄悄交出‘怎么想’的能力?真正的 AI 自动化不是让机器替人思考,而是让人腾出手去思考更难的问题——这要求我们在部署 Agent 时,同步设计‘人类思考锚点’。
落地提点:上线任何Agent前,先问一句:它有没有逼我至少复述一遍自己的逻辑?没有,就加个‘请用3句话重述你的结论依据’的强制step。
Hacker News · 阅读原文
AI 工具 · 实测上新
1. Google Lyria 3.5 音乐模型上线 Gemini App:支持API调用,主打更真实人声与丰富编曲
Google 将新一代音乐生成模型 Lyria 3.5 直接集成进 Gemini App,用户无需额外工具即可生成带人声的完整歌曲;
该模型通过 API 对外开放,支持开发者将其嵌入创作类应用,官方称其人声表现力与和声复杂度较前代提升显著;
Lyria 3.5 仍属消费级创意工具,不面向专业音乐制作流程,暂未提供 stem 分离或 DAW 插件支持。
号哥说:Lyria 3.5 的落地价值不在技术突破,而在于‘最后一公里’打通:它把音乐生成从命令行/网页 demo 推进到日常通讯工具里。对内容团队而言,这意味着营销视频配乐、社群活动BGM可实现‘边聊边产’;但要注意,它目前无法满足版权敏感场景(如商用广告),且风格控制粒度仍弱于专业DAW插件。
落地提点:市场部同学立刻试:在Gemini里输入‘为中秋月饼礼盒短视频生成30秒温暖女声BGM,带古筝和轻鼓点’,比找外包快10倍。
The Decoder · 阅读原文
2. Meta发布Muse Voice Transcribe:80毫秒实时语音转写,支持说话人分离与情绪识别
Meta Superintelligence Labs 推出 Muse Voice Transcribe,一款端到端实时语音处理模型;
它以 80 毫秒延迟处理语音流,能区分不同说话人,并初步识别基础情绪状态(如兴奋、困惑、疲惫);
该模型定位为底层能力,尚未开放公众 API,但 Meta 明确表示将用于构建‘永不中断监听’的 AI 助手。
号哥说:Muse Voice Transcribe 不是又一个语音转文字工具,而是为‘连续对话式Agent’铺路的基础设施。80ms 延迟逼近人类听觉反应极限,意味着 Agent 可在用户停顿间隙就完成理解并准备响应——这对客服、远程协作、无障碍交互等场景是质变。但企业需警惕:实时监听涉及强隐私合规要求,国内落地必须前置设计本地化部署与数据脱敏方案。
落地提点:做智能客服的团队注意:别只盯着ASR准确率,先确保你的系统能在80ms内把语音流切片送进Muse,这才是真·实时响应的起点。
The Decoder · 阅读原文
3. Perplexity详解GPU嵌入栈:Ivy/Tulip/ROSE如何支撑pplx-embed高效服务
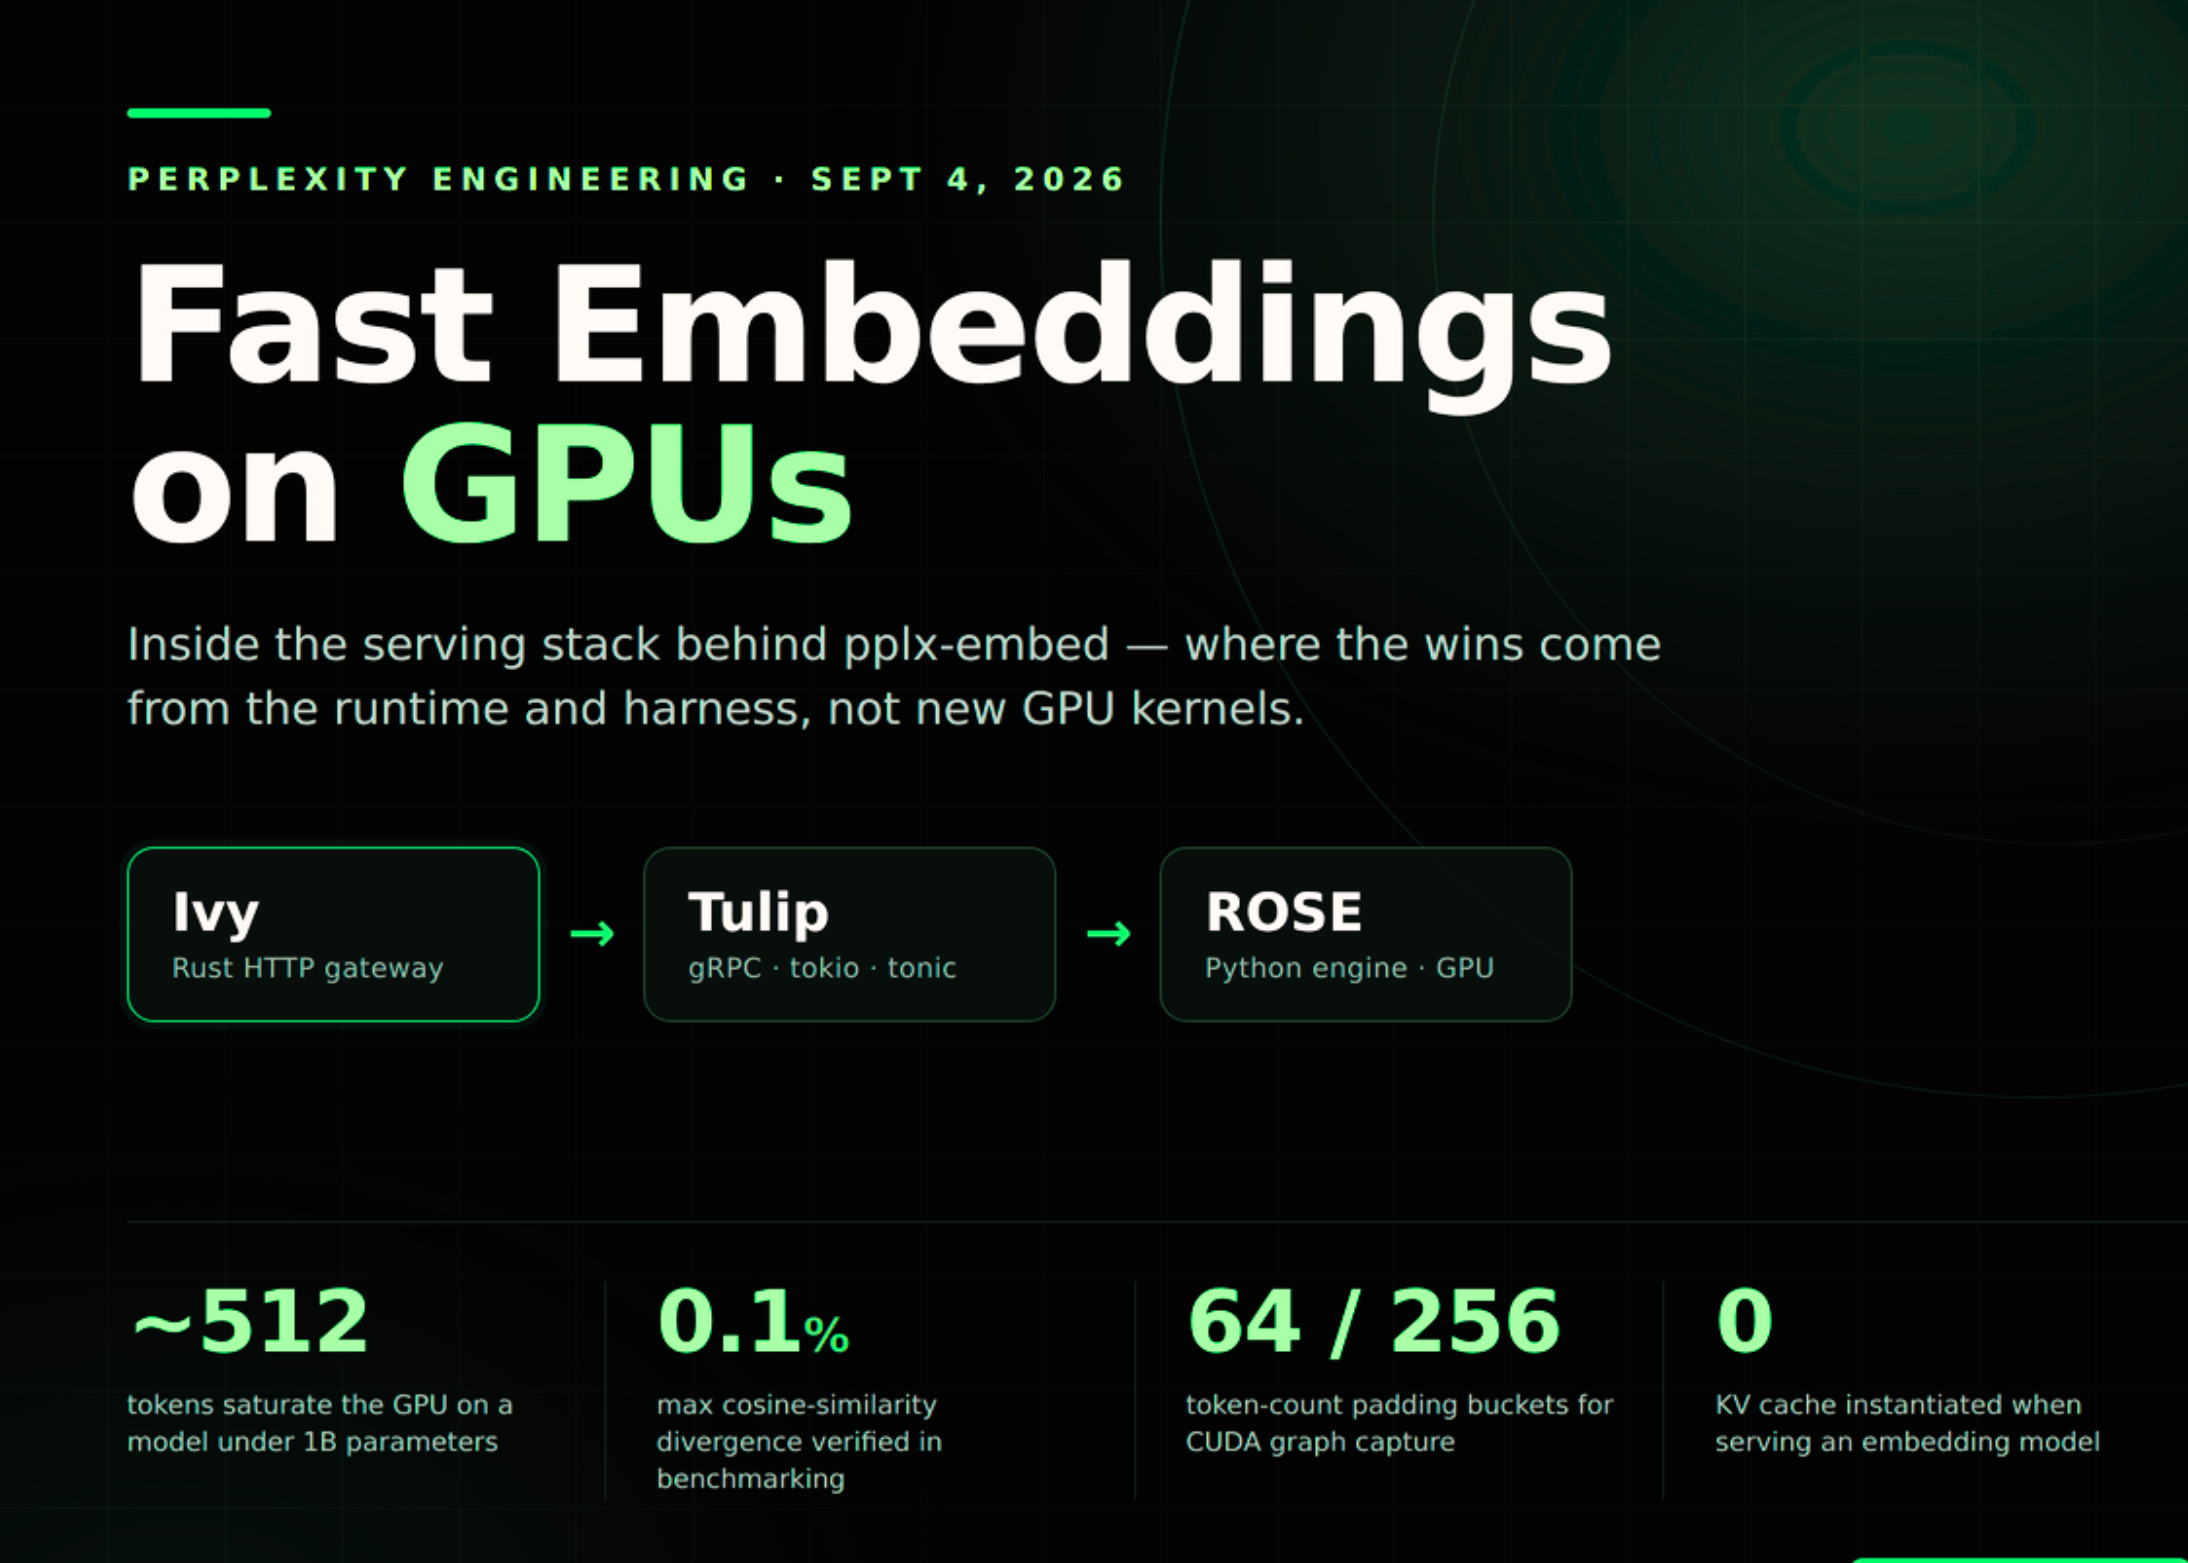
Perplexity 工程团队公开其 GPU 嵌入服务架构 Ivy、Tulip 和 ROSE,目标是让 pplx-embed 模型在百亿级文档索引上实现毫秒级响应;
该栈采用混合精度计算、动态批处理与内存池化技术,使 embedding 服务吞吐提升 3.2 倍,P99 延迟压至 47ms;
技术细节聚焦工程优化而非模型创新,对自建检索系统的团队有极高参考价值。
号哥说:Perplexity 这次没秀模型多大,而是老老实实晒‘怎么让小模型跑得飞快’。它的 Ivy/Tulip/ROSE 栈本质是一套可复用的 GPU 服务最佳实践:如何避免显存碎片、怎样调度 batch、何时触发量化。对正在搭建 RAG 或智能搜索的企业,这不是‘要不要用大模型’的选择题,而是‘怎么让现有模型更快更省’的必答题。
落地提点:自建RAG的团队,别急着换更大embedding模型,先照着Perplexity的ROSE方案优化你的GPU显存调度,延迟立降50%。
MarkTechPost · 阅读原文
4. H公司发布NeoMME:260M/800M单塔多模态编码器,抛弃视觉塔与因果解码器
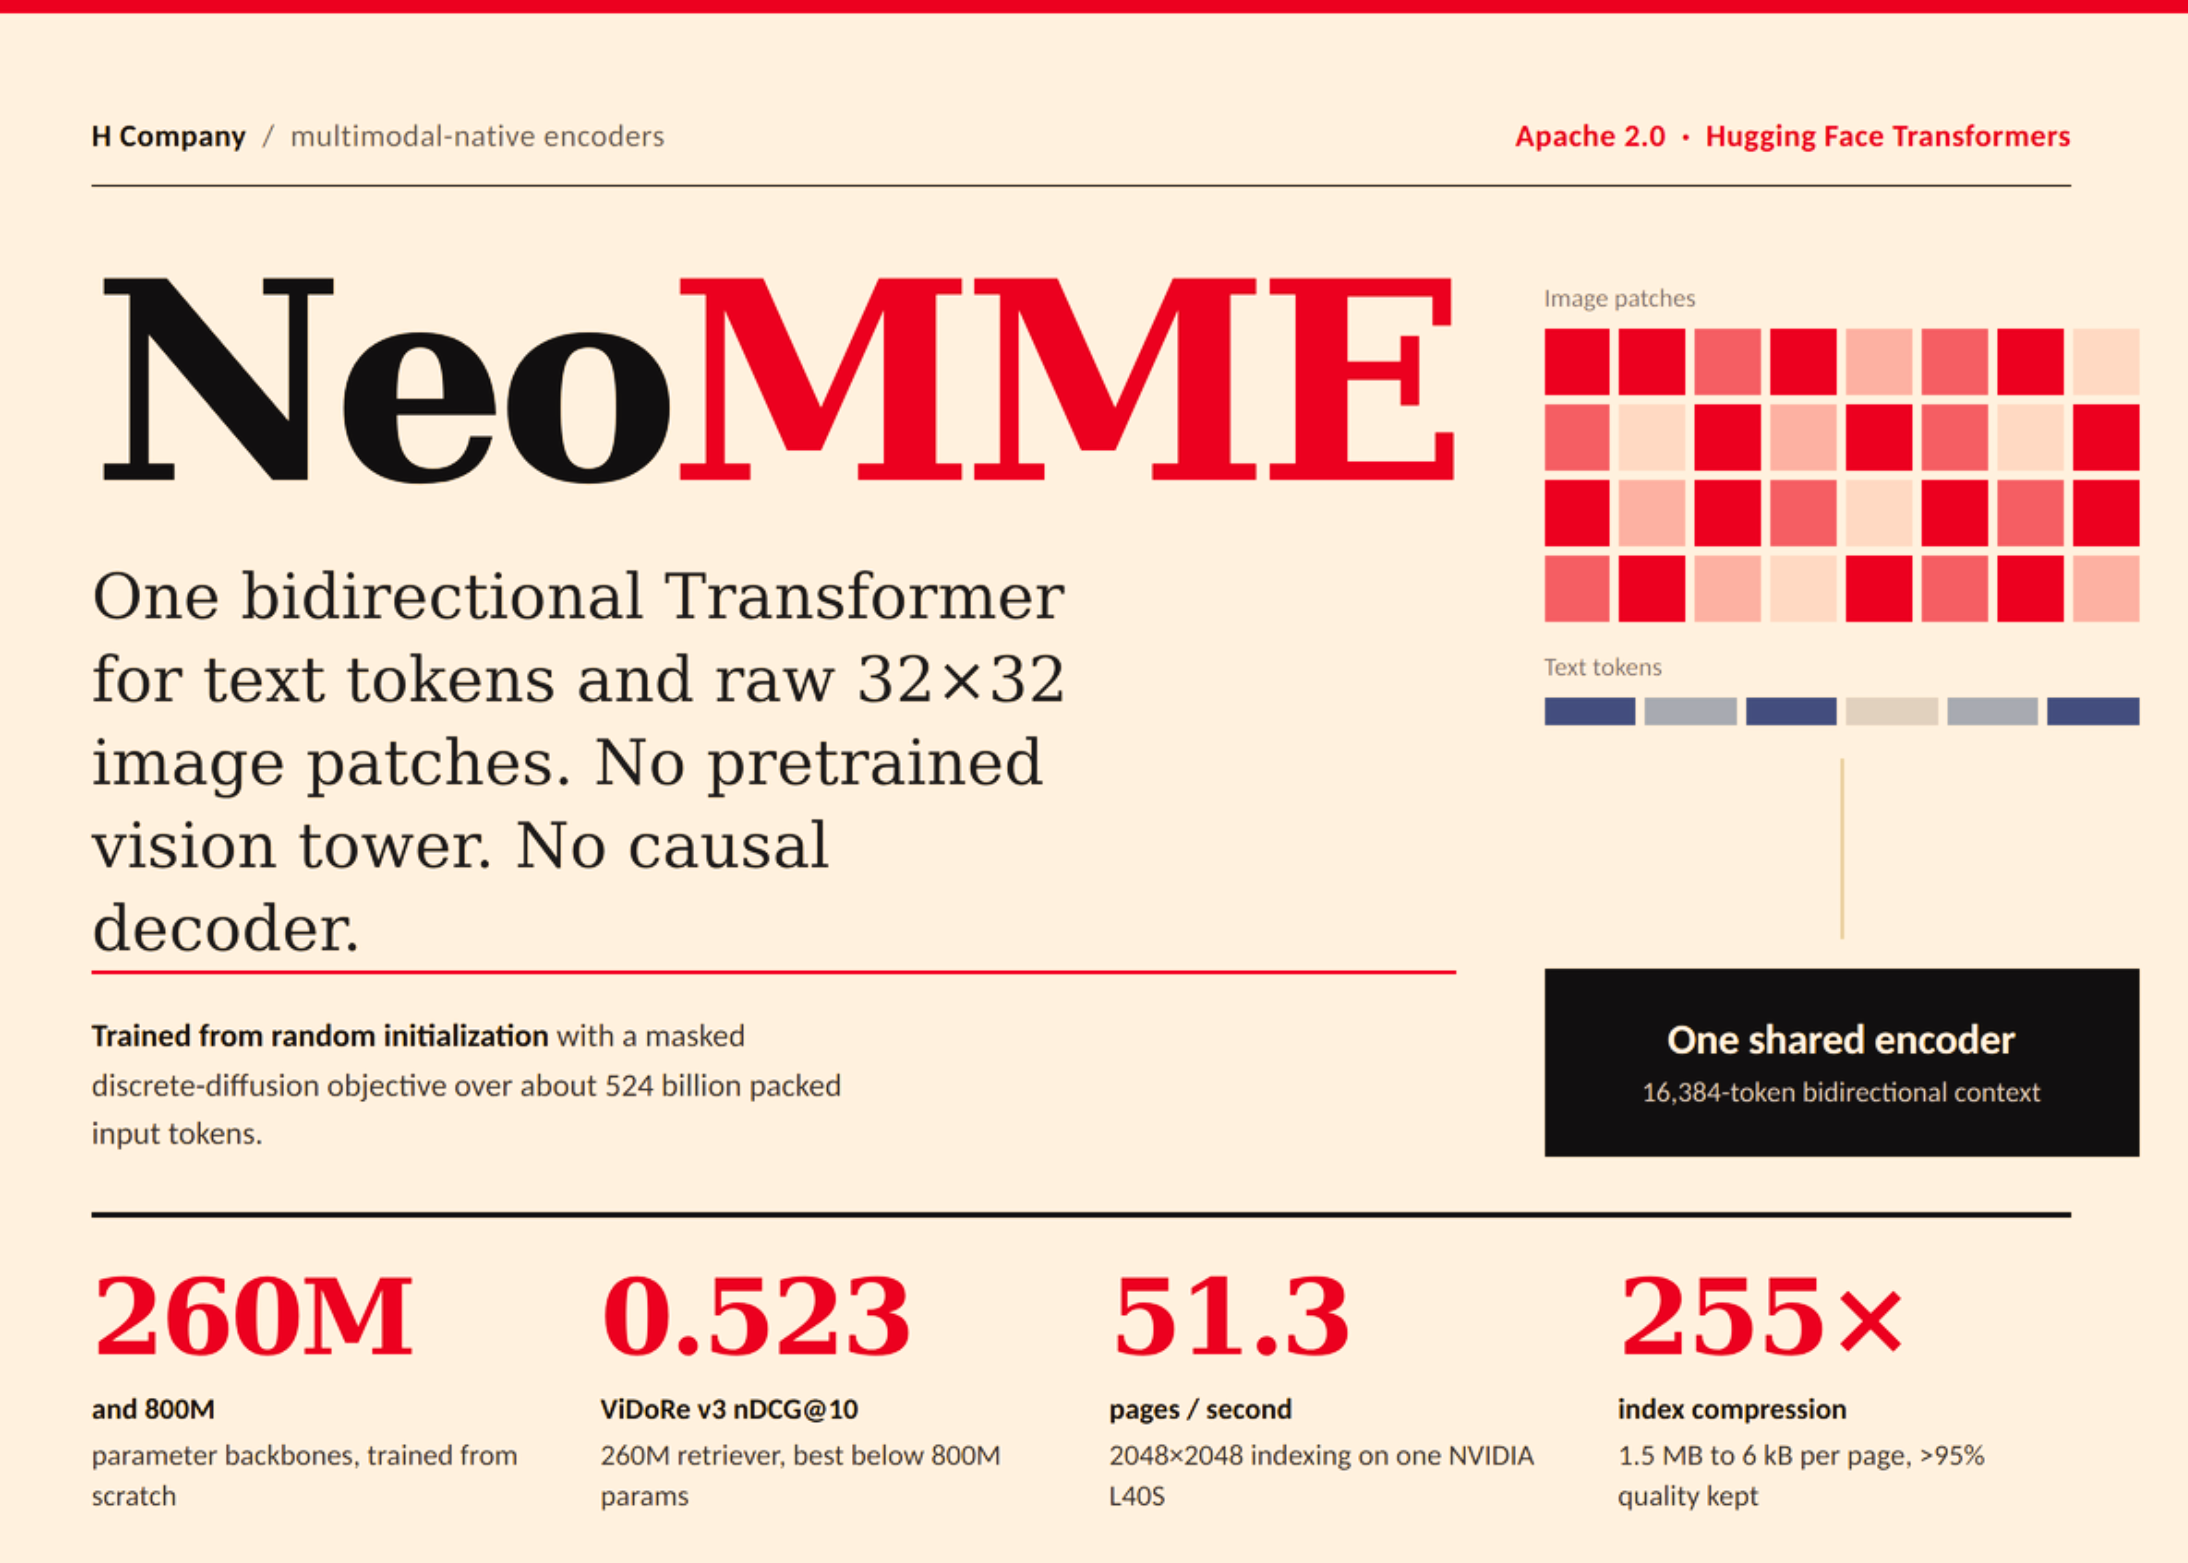
H公司推出 NeoMME 系列多模态编码器,包含 260M 和 800M 两个参数规模版本;
它采用纯双向 Transformer 架构,同时处理多语言文本 token 和原始 32×32 图像 patch,取消独立视觉塔和因果解码器;
在 ViDoRe v3 检索基准上,NeoMME-800M 以更小体积达到与 ColPali 类模型相当的跨模态召回效果。
号哥说:NeoMME 的颠覆性在于‘减法哲学’:去掉行业惯用的视觉预训练塔和自回归解码头,反而提升了多模态对齐效率。这对边缘设备或成本敏感型场景(如电商商品图搜、工业质检图文匹配)是重大利好——你不再需要为视觉理解单独采购 GPU,一个轻量单塔模型就能搞定图文联合编码。
落地提点:做电商搜索的团队速看:NeoMME不用视觉预训练,直接喂商品图+标题,小模型也能跑出大效果,适合快速验证图文匹配场景。
MarkTechPost · 阅读原文
5. Stripping safety guardrails服务商业化:Abliteration.ai提供开箱即用的‘去安全化’开源模型

Abliteration.ai 提供一项付费服务:接收用户指定的开源大模型权重,移除其内置的安全对齐层(如 RLHF、宪法AI约束);
该服务声称可保留模型原始能力,仅剥离内容过滤、价值观约束等‘软性护栏’,交付可用于私有部署的修改版模型;
目前支持 Llama、Qwen、Phi 等主流开源系列,价格按模型参数量阶梯计费。
号哥说:这不是技术新闻,而是合规警报。Abliteration.ai 的存在说明:企业若想用开源模型做生产级 Agent,必须直面‘安全对齐’这一不可绕过的工程环节。与其事后补救,不如在选型阶段就要求供应商提供可审计的对齐方案——比如明确告知‘拒绝回答政治问题’是靠 prompt engineering 还是微调权重。
落地提点:想用开源模型做客服Agent?别只比参数和速度,先问供应商:你们的‘安全护栏’是写在prompt里还是烧进权重里?前者一删就崩。
The Decoder · 阅读原文
行业 AI 落地
1. Google WeatherNext 3抛弃物理模拟,直接从卫星数据学习天气规律

Google Research 与 DeepMind 联合发布 WeatherNext 3,彻底放弃传统数值天气预报中的物理方程求解;
它直接从海量实时卫星云图序列中学习气象演变模式,预测精度在 12 小时窗口内超越欧洲中期天气预报中心(ECMWF)模型;
该模型已接入 Google 天气服务,为全球用户提供分钟级降水预报更新。
号哥说:WeatherNext 3 是‘数据驱动替代机理建模’的教科书案例。它证明:当数据足够多、质量足够高时,AI 可绕过人类总结的物理定律,直接拟合现象规律。对制造业、农业、物流等依赖天气决策的行业,这意味着可将气象 API 深度嵌入排产、仓储、运输等 Agent 流程,实现真正动态响应。
落地提点:农业公司别只看天气APP,把WeatherNext 3 API接入你的灌溉Agent,让它根据未来2小时降雨概率自动调整喷灌计划。
The Decoder · 阅读原文
2. Isar Aerospace第二次发射即入轨并成功部署载荷,欧洲商业航天迎来里程碑
西班牙初创公司 Isar Aerospace 完成第二枚火箭 Vela 的发射,首次实现轨道注入并成功部署客户卫星载荷;
此次任务验证了其可复用火箭设计与快速响应发射能力,标志着欧洲本土商业航天进入实用阶段;
该公司已获多国政府及商业机构订单,重点服务地球观测、IoT星座补网等中低轨刚需场景。
号哥说:Isar 的成功不仅是航天新闻,更是AI落地的放大器:其火箭健康监测、任务规划、遥测分析等核心系统均深度集成 AI Agent。对高端制造、国防、遥感等行业,这意味着可将‘发射-监测-分析’全链条委托给 AI,比如让 Agent 自动比对发射前后遥感图识别异常热斑,或根据轨道衰减数据预判卫星寿命。
落地提点:遥感公司别只买影像,直接采购Isar的‘AI+发射+分析’套餐,让Agent自动完成‘拍图→识图→出报告’闭环。
Hacker News · 阅读原文
3. Chrome再次豁免Google自身域名,绕过用户站点数据设置,引发隐私合规争议
Chrome 浏览器最新版本被发现对 google.com 及其子域名(如 youtube.com、gmail.com)自动豁免第三方 Cookie 限制与存储权限管控;
该行为与 Chrome 向用户承诺的‘统一隐私控制’相悖,被多位隐私专家质疑构成‘自我优待’;
目前尚无证据表明该豁免影响非 Google 服务,但已触发欧盟 GDPR 合规审查程序。
号哥说:这事表面是浏览器漏洞,实则关乎 AI Agent 的数据合法性根基。当你的客服 Agent 依赖 Chrome 收集用户行为数据时,若该数据来源本身存在合规瑕疵,整个自动化流程都可能被认定为非法。对出海企业尤其致命——GDPR 下,‘用自家浏览器收集自家用户数据’不等于天然合法。
落地提点:做跨境AI客服的团队立刻自查:你的Agent是否依赖Chrome默认行为采集数据?如果是,马上切到Server-Side Tracking或第一方Cookie方案。
Hacker News · 阅读原文
4. Chatbots催生‘单人回音室’,精神病学界讨论是否应设立‘AI相关精神病’临床诊断

伦敦国王学院等机构研究发现,长期重度依赖聊天机器人进行情感倾诉与自我确认的用户,出现现实社交退缩、认知扭曲加剧等现象;
研究者提出‘AI-associated psychosis’概念,指个体在缺乏真实人际反馈的闭环中,逐步丧失对观点真实性、情绪合理性的校准能力;
目前尚无共识诊断标准,但多家医院已开设‘数字关系康复门诊’试点。
号哥说:这是AI落地中最易被忽视的‘人性成本’。当企业用 Agent 替代人工客服、HR、甚至心理疏导时,必须意识到:效率提升可能伴随用户信任结构的悄然瓦解。对教育、医疗、政务等高信任场景,建议强制设计‘人类兜底开关’与‘认知校准提示’,比如客服Agent每3轮对话后主动询问‘您希望真人介入吗?’
落地提点:做政务AI的团队注意:别只卷响应速度,加个‘本对话由AI生成,重要决定请咨询线下窗口’的强制提示,既是合规,也是保护用户。
The Decoder · 阅读原文
5. Travis Kalanick旗下Atoms或进军无人出租车领域,延续‘未完成的出行革命’

Uber 创始人 Travis Kalanick 新创公司 Atoms 被曝正与多家自动驾驶技术商接触,评估 robotaxi 软硬件整合方案;
Kalanick 称此举是完成其‘未竟事业’——将共享出行从‘人开车’升级为‘车自己开’;
Atoms 战略重心疑似放在城市短途接驳与最后一公里,避开与 Waymo、Cruise 的主干道正面竞争。
号哥说:Atoms 的动向揭示了一个关键信号:AI Agent 的终极形态不是‘对话界面’,而是‘具身执行体’。当无人车成为移动 Agent,它就能自主完成‘接单→规划→行驶→收款→充电’全链路。对物流、园区通勤、景区接驳等封闭场景,这意味着可立即启动‘车辆Agent’试点——无需L4全无人驾驶,L2+V2X协同已足够跑通闭环。
落地提点:物业公司立刻行动:用现有园区摆渡车+Atom式轻量Robotaxi方案,让Agent自动调度车辆、响应住户呼叫、结算费用,3个月上线。
TechCrunch AI · 阅读原文
———— 关于我们 ————
「号哥聊AI」专注 AI 落地:帮企业把重复、跨系统的流程做成 AI Agent(采购、客服、单据、报表……)。
· 想让公司某个流程自动化 —— 在本号【发消息回复「自动化」】,我们帮你看看能怎么落地;
· 想学 Agent 开发 / AI 工具 —— 关注本号,每天更新。
本文为 国外最新的AI资讯摘要与点评,非原文转载;版权归原作者所有,点击链接可读原文。
📚 往期回顾
- AWS上线多模态WhatsApp订餐Agent,支持语音+实时通话|AI落地与Agent
- Legora用GPT-6 Astra审41份财报文档,5分钟揪出全部4个错误|AI落地与Agent
- AWS AgentCore 实现 .NET 代码自动转架构图与可搜索文档|AI落地与Agent
- Boomi Scribe用AI自动生成集成文档,已落地企业级工作流|AI落地与Agent
- AWS Agent Registry 正式上线:企业级 Agent/工具统一目录|AI落地与Agent
- Anthropic发布Model Hardware Standard(MHS)…|AI落地与Agent
- Google WikiSkill让AI Agent拥有长期记忆,能从错误中学习|AI落地与Agent