AWS 推出 AgentCore 评估+DevOps Agent 双监控体系|AI落地与Agent
有人把整套报关流程交给了 Agent,人只签字;现在 AWS 告诉你:Agent 上线后怎么不翻车?
▍今日主打
AWS 推出双层监控体系:AgentCore 评估 + DevOps Agent 自主排障
这篇 AWS 博客首次系统性披露了生产级多 Agent 系统的「可观测性」落地方案:不是简单看 token 消耗或响应延迟,而是用 AgentCore Evaluations(质量评分)+ AWS DevOps Agent(自主故障排查)构成双层监控。前者在每次调用后生成结构化质量分数(如意图理解准确率、工具调用成功率、结果完整性),后者能自动触发 CloudWatch 事件、执行 Lambda 排查脚本、甚至回滚错误状态——它本身就是一个可调度的 Agent。
对想给公司上 Agent 的人来说,这意味着:你不必从零设计监控埋点,AWS 已把「Agent 行为是否合规、结果是否可靠、故障是否自愈」拆解成可配置、可告警、可审计的指标;对开发者而言,这套模式可直接复用于采购审批、客服工单、财务对账等任何需要长周期自治的流程——关键不是「有没有 Agent」,而是「它干得对不对、出错了能不能自己修」。
我们判断:这套方案适合已有 Bedrock 应用、正推进 Agent 落地的中大型企业,尤其适合强合规要求场景(如金融、政务)。小团队不必硬搬整套,但务必借鉴其思路:上线前先定义「什么算干得好」(比如合同审核通过率>95%)、再设计「怎么发现干得不好」(比如连续3次工具调用失败触发人工介入)。别等上线后靠用户投诉才发现 Agent 在瞎编条款。
—— 以下是今天的全部 15 条速览 ——
Agent 与流程自动化
1. AWS 推出双层监控体系:AgentCore 评估 + DevOps Agent 自主排障

AWS 提出针对生产环境多 Agent 系统的新型监控范式,解决传统 APM 工具无法捕捉 Agent 行为异常的问题;
AgentCore Evaluations 提供细粒度质量评分(如任务完成度、工具调用正确率、响应一致性),支持持续追踪 Agent 质量衰减;
AWS DevOps Agent 是一个可调度的自治 Agent,能基于监控信号自动执行基础设施诊断、日志分析与修复动作,已在四 Agent 航空预订系统中验证。
号哥说:这是目前最接近企业级 Agent 运维标准的实操方案——它不讲‘Agent 多聪明’,而聚焦‘它出错时你怎么知道、怎么止损’。对正在将客服/采购/法务流程交给 Agent 的企业,这才是真刚需:不是让 Agent 上线,而是让它上线后不掉链子。
落地提点:别急着堆功能,先想清楚:你的 Agent 干砸了,系统能自动发现并叫停吗?AWS 这套就是告诉你‘怎么设这个哨兵’。
AWS Machine Learning Blog · 阅读原文
2. OpenAI Agents API 正式公测:Codex 底座开放,支持长周期自治与沙箱隔离
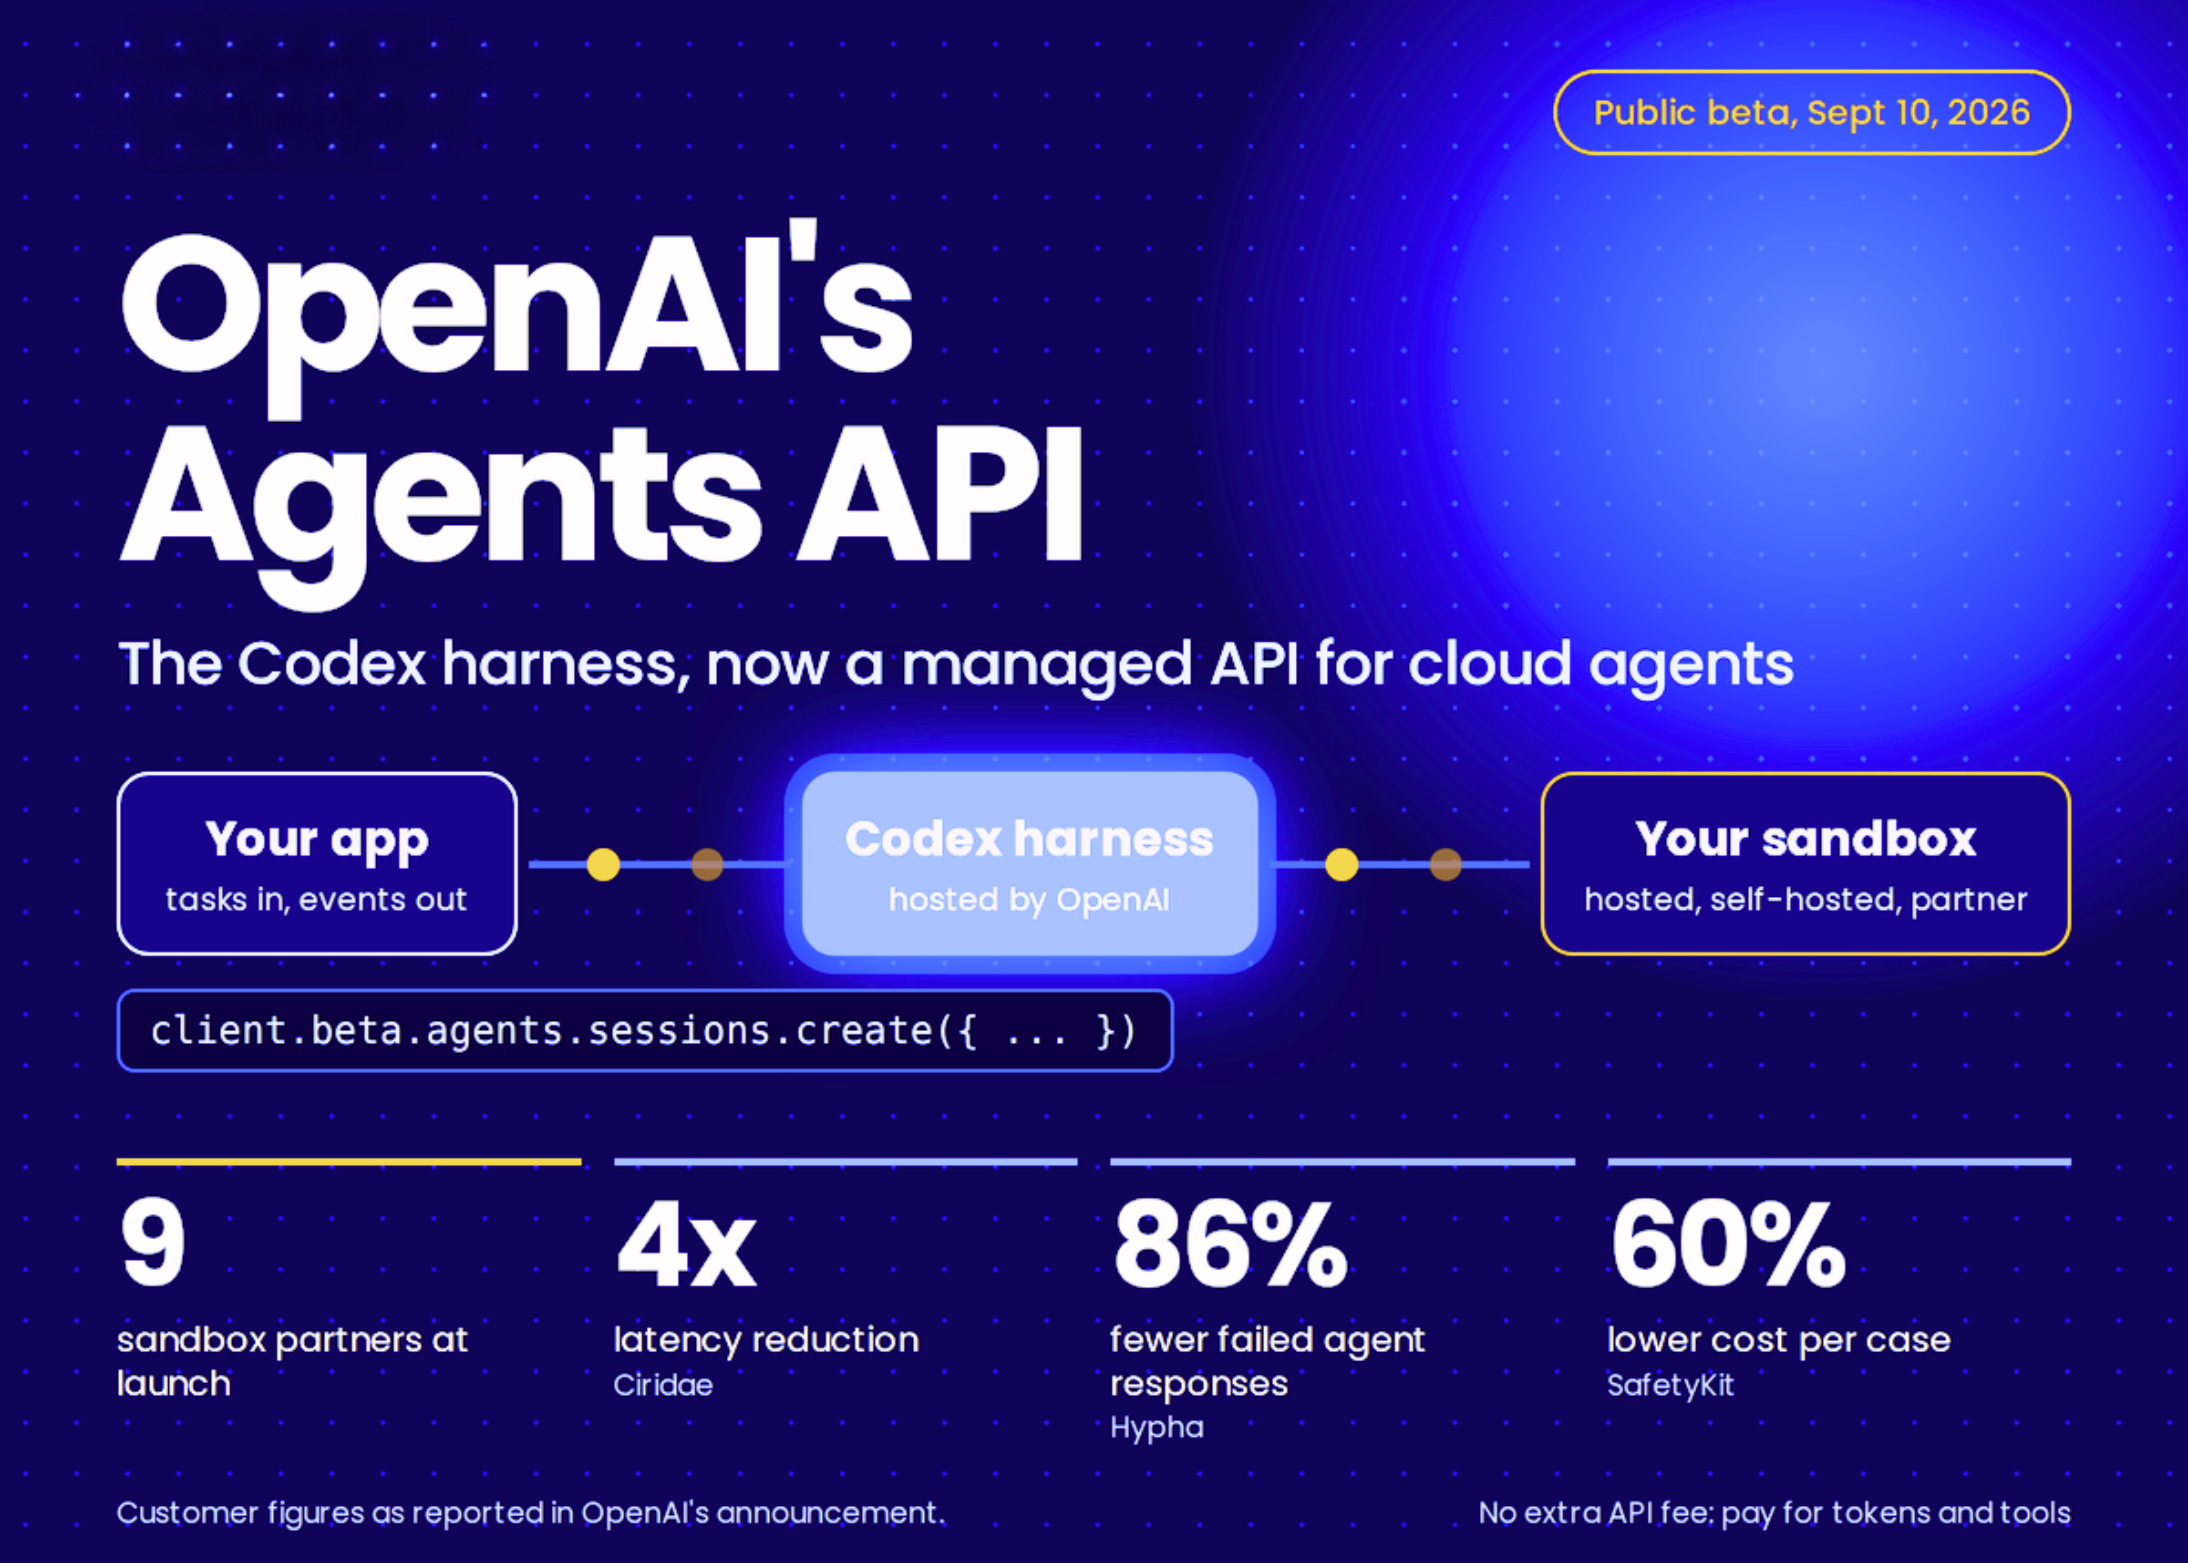
OpenAI 将支撑 Codex 和 ChatGPT 的底层 Agent 运行时(harness)封装为统一 API,开发者无需自建调度、记忆、工具调用框架;
API 支持 Agent 在 OpenAI 托管沙箱、客户自有基础设施或第三方沙箱中运行,最长可持续执行数小时;
开发者只需定义工具集、提示词与终止条件,其余生命周期管理(重试、降级、超时、状态持久化)均由 OpenAI 托管。
号哥说:这标志着 Agent 开发正式进入‘基础设施即服务’阶段。相比自研框架,它省去 70% 以上工程成本,但代价是数据不出域受限、调试深度有限。适合希望快速验证业务闭环的团队,而非追求极致可控性的安全敏感型场景。
落地提点:适合想两周内跑通一个采购申请 Agent 的业务方——别自己搭 harness,直接调用 API,把精力放在定义‘审批规则’和‘对接 ERP’上。
MarkTechPost · 阅读原文
3. Anthropic 发布插件评估新流程:6 类评分器 + 无插件基线 + CI 门禁
Anthropic 为 Claude Code 插件开发者推出标准化评估命令 claude plugin eval,覆盖技能触发率、输出质量、安全性等 6 维度;
引入‘无插件运行’对照组,量化插件真实增益,避免虚假提升;
支持接入 CI 流程,在代码合并前拦截未达标的插件变更,成为技能上线的强制门禁。
号哥说:这是首个将 AI 技能发布流程纳入软件工程规范的实践。它把过去靠人工抽查的‘插件好不好用’,变成可自动化、可版本化、可准入卡控的质量门禁——对构建企业级 AI 技能市场有示范意义。
落地提点:如果你在搭建内部 AI 工具平台,立刻抄作业:没有评估门禁的插件,就像没单元测试的代码,上线=埋雷。
MarkTechPost · 阅读原文
4. Sakana AI 发布 Fugu Max/Ultra v2:低成本多 Agent 编排模型,支持按需路由至专用模型

Fugu Max 采用动态路由架构,将任务分发至轻量开源模型(如 NVIDIA Nemotron)或垂类专用模型,token 成本低至 $2/百万;
Fugu Ultra v2 专注能力峰值,在 Chartography(图表理解)达 48.3 分、DeepSWE(代码评测)达 74.3 分;
两者均基于同一学习型编排架构,可在推理时根据任务复杂度自动选择最优路径。
号哥说:它直击当前多 Agent 系统最大痛点:‘大模型全包’太贵,‘小模型乱配’不准。Fugu 的价值不在参数量,而在‘什么时候该叫谁来干活’的决策智能——这对需要平衡成本与效果的中台型 Agent 架构极具参考价值。
落地提点:适合做 Agent 中台的团队:别死磕单一大模型,学 Fugu 用编排逻辑把开源小模型、垂类模型、API 工具串成一条流水线。
MarkTechPost · 阅读原文
5. Google ToolGrad 框架:答案优先的数据生成法,工具调用数据集构建成功率提升至 99.8%
ToolGrad 颠覆传统:先构造验证通过的 API 调用链,再反向生成匹配的自然语言查询,确保每条数据都‘能跑通’;
采用四模块循环(propose-execute-select-update)生成文本梯度,引导模型精准对齐工具行为;
仅用 500 条样本微调 Gemma-3-12B,即可在 ToolBench 上达到 80%+ 工具调用准确率。
号哥说:高质量工具调用数据是 Agent 能力的基石,但手工标注成本极高。ToolGrad 提供了一种工业化量产方案——它让‘数据生成’本身成为一个可编程、可验证、可迭代的过程,大幅降低企业定制 Agent 的数据门槛。
落地提点:想训练自家客服 Agent?别再人工写 1000 条‘查订单’样例,用 ToolGrad 自动生成带真实 API 调用路径的语料,效率翻倍。
MarkTechPost · 阅读原文
AI 工具 · 实测上新
1. Amazon Bedrock 新增 Marengo 3.0:支持视频/图像/音频内容的自然语言语义搜索
TwelveLabs Marengo Embed 3.0 成为 Bedrock Knowledge Base 内置嵌入模型,支持跨模态内容向量化;
用户可用自然语言提问(如‘找出所有展示产品包装破损的质检视频片段’),系统自动定位视频帧、图像区域及音频关键词;
全程由 AWS 托管,无需客户自行部署多模态模型或构建特征 pipeline。
号哥说:这是企业知识库能力的一次跃迁:过去只能搜文档关键词,现在能直接问‘上个月客户投诉里提到‘漏液’的视频有哪些’。对制造业质检、电商直播复盘、安防事件回溯等场景,意味着从‘查资料’升级为‘找证据’。
落地提点:适合有大量非结构化音视频资产的企业:别再花人力转录剪辑,用 Marengo 3.0 让 AI 直接听懂视频、看懂画面、找到你要的那一秒。
AWS Machine Learning Blog · 阅读原文
2. AWS 发布交互式 MCP App 构建指南:HTML 小部件无缝接入 ChatGPT/Claude

基于 Amazon Bedrock AgentCore,开发者可构建含按钮、表单、图表等 HTML 交互组件的 MCP App;
MCP(Model Communication Protocol)是主机无关标准,同一套前端代码可在支持 MCP 的任意 AI 主机(如 ChatGPT、Claude)中运行;
教程提供完整部署流程,包括本地调试、Bedrock 集成与跨平台兼容性验证。
号哥说:MCP 正在成为 AI 应用的‘USB-C 接口’:它让交互逻辑与模型解耦。企业不再需要为每个大模型单独开发 UI,一套 MCP App 即可覆盖主流平台——这对想快速上线 AI 助手的 SaaS 厂商是重大利好。
落地提点:做 ToB SaaS 的朋友注意:下次给客户加 AI 功能,别再写三套前端,用 MCP 标准一次开发,全平台部署。
AWS Machine Learning Blog · 阅读原文
3. OpenRouter 新增自动降级与成本优化路由,支持单接口调用多后端模型
OpenRouter 提供统一 API 入口,自动根据请求类型、实时负载、价格波动,将请求路由至最优后端模型(如 GPT-4o、Claude-3.5、Llama-3.1);
内置 fallback 机制,当首选模型不可用时无缝切换至备选,保障 SLA;
开发者无需修改代码,仅需配置偏好权重(如‘速度优先’或‘成本最低’),平台自动决策。
号哥说:它把模型选型这个‘玄学决策’变成了可配置的基础设施。对中小团队而言,这意味着用一个 API 就能享受头部模型的弹性与开源模型的成本优势,避免被单一供应商绑定。
落地提点:小团队做 PoC 别再纠结选哪个模型——用 OpenRouter,让它自动帮你挑最划算的那个,省下的钱够买半年服务器。
Simon Willison · 阅读原文
4. Cohere 发布 North Small Translate:218B MoE 开源翻译模型,支持 50 种语言,WMT26 得分 83.6

North Small Translate 是 Mixture-of-Experts 架构,每次推理仅激活 25B 参数,兼顾性能与效率;
在 Cohere 自建 WMT26 多语言评测集上取得 83.6 分,显著优于同规模开源模型;
模型权重免费开放非商用,商业用途可通过 Cohere Model Vault 或 RWS Language Weaver 获取授权。
号哥说:它填补了高质量、多语言、可商用开源翻译模型的空白。对跨境电商、全球化 SaaS、多语种客服系统而言,这意味着摆脱 Google/Baidu API 依赖,用自有模型实现低延迟、高可控的实时翻译。
落地提点:做跨境业务的公司,立刻下载试跑:用 North 替代百度翻译 API,既能保数据不出境,又能省下每年几十万调用费。
MarkTechPost · 阅读原文
5. ByteDance Seed 发布 HarnessDev 基准:评估 LLM 自建 Agent 框架的可运行性而非答案正确率

HarnessDev 不考核模型回答是否正确,而是评估其生成的 Agent 运行时框架(harness)能否真正执行成功;
涵盖 5 大基准、2207 个任务,要求模型从零构建可部署、可调试、可扩展的 harness 代码;
实验显示,6 个主流 LLM 生成的 harness 中,仅 34/64 具备跨任务泛化能力,人类编写仍具明显优势。
号哥说:这是首个将‘Agent 工程能力’从‘语言能力’中剥离出来的测评标准。它揭示了一个关键事实:让模型写代码容易,但让它写出稳定、健壮、可运维的 Agent 框架,仍是巨大挑战——对企业技术选型有警示意义。
落地提点:别迷信‘LLM 能写 Agent 代码’,HarnessDev 证明:真正可靠的 Agent 框架,还得靠工程师亲手打磨。
MarkTechPost · 阅读原文
行业 AI 落地
1. Meta Muse 成为美国下载量第二的 App:AI 代理正从工具走向日常入口

Meta 新推出的 AI 代理应用 Muse 上线即登顶美国 App Store 下载榜第二,仅次于 TikTok;
Muse 定位为个人 AI 助理,整合 Messenger、WhatsApp、Instagram 消息与日程管理,支持跨平台任务协同;
用户反馈显示,高频使用场景集中于‘自动整理会议纪要’‘跨聊天记录汇总项目进度’‘预约餐厅并同步日历’。
号哥说:这不是又一个聊天机器人,而是首个以‘代理’身份深度嵌入用户数字生活的 App。它的爆发说明:当 AI 能主动跨应用完成任务,用户愿意为其让出手机主屏——这对所有 ToC 产品都是信号:你的 App 是否准备好被 Muse 调用?
落地提点:ToC 产品经理快检查:你的 App 有没有开放 API 或 MCP 接口?否则 Muse 未来可能绕过你,直接替用户操作你的竞品。
TechCrunch AI · 阅读原文
2. 墨西哥学生研发声波灭火器:利用特定频率声波隔绝氧气,3 秒扑灭明火
16 岁墨西哥学生开发便携式声波灭火设备,通过扬声器发射 30–60Hz 低频声波形成气流屏障,物理隔绝火焰周围氧气;
原型机已通过实验室测试,对纸张、木材等固体燃料明火灭火时间<3 秒,且不损伤物品、不留残留;
技术原理已申请专利,正寻求与消防设备厂商合作产业化。
号哥说:这不是科幻,而是声学物理在现实场景的精准应用。它提醒我们:AI 落地不必总盯着大模型,有时一个被忽视的基础学科突破(如声波控制),结合微型化硬件,就能催生颠覆性工业解决方案。
落地提点:制造业安全负责人注意:别只盯着 AI 视觉巡检,这种无水无化学残留的声波灭火,可能是车间精密设备防火的新选项。
Hacker News · 阅读原文
3. New Mexico 法院裁定律师因使用 AI 编造证人证词被罚 5000 美元

新墨西哥州最高法院认定律师 Stephen Aarons 在谋杀案上诉中提交由 ChatGPT 生成的虚构证人证词与假警察报告,构成严重失职;
法院强调:律师有绝对义务核实 AI 输出内容的真实性,不能以‘不知道是假的’为免责理由;
该案成为美国首例因 AI 事实性错误导致司法惩戒的判例,已引发全美律协紧急修订执业指引。
号哥说:这起判例划清了 AI 辅助与 AI 甩锅的法律红线。它倒逼法律、医疗、金融等强责任行业重新设计工作流:AI 只能提建议,关键结论必须经人类交叉验证并留痕——否则,板子打在具体执行人身上。
落地提点:专业服务机构立刻行动:在合同里明确 AI 使用边界,在系统里强制添加‘人工复核’步骤并自动存证,否则下一个被罚的就是你。
The Verge AI · 阅读原文
4. OpenAI Navier-Stokes 模型附带 Lean 4 形式化证明:AI 科研成果正迈向数学级可验证
OpenAI 发布 Navier-Stokes 方程求解模型,同步公开其核心算法的 Lean 4 形式化证明文件;
该证明经计算机辅助验证,确认模型推导过程符合数学公理系统,杜绝逻辑漏洞;
此举将 AI 科研从‘实验可复现’推向‘逻辑可验证’,为物理仿真、芯片设计等高可靠性领域铺路。
号哥说:这是 AI 与形式化方法的里程碑融合。当模型不仅‘算得对’,还能‘证得明’,它就具备了进入航天、核电、药物研发等‘零容错’领域的资格——科研机构和高端制造企业应重点关注此类可验证 AI 的演进。
落地提点:搞仿真的工程师别只看精度,下次选模型前先查查它有没有配套的形式化证明,那才是真·军工级可靠。
Hacker News · 阅读原文
5. Instagram 头部负责人证实:关闭算法推荐后用户互动率下降 50%
Instagram CEO Adam Mosseri 向澳大利亚监管机构证实,若移除个性化推荐算法,用户平均每日互动次数(点赞、评论、分享)下降约 50%;
该数据来自澳大利亚强制算法透明化试点,验证了推荐系统对用户粘性的核心作用;
Meta 表示正探索‘可解释推荐’方案,在保持效果的同时提升用户控制权。
号哥说:算法不是黑箱,而是现代数字产品的‘氧气’。这一数据给所有依赖用户活跃度的平台敲响警钟:当 AI 推荐能力被削弱,流量、广告、增长模型都将坍塌——企业级 AI 落地必须正视其基础性地位。
落地提点:做用户运营的同学记住:你的增长策略如果没把 AI 推荐作为底层变量,那大概率是在空中建楼。
Hacker News · 阅读原文
———— 关于我们 ————
「号哥聊AI」专注 AI 落地:帮企业把重复、跨系统的流程做成 AI Agent(采购、客服、单据、报表……)。
· 想让公司某个流程自动化 —— 在本号【发消息回复「自动化」】,我们帮你看看能怎么落地;
· 想学 Agent 开发 / AI 工具 —— 关注本号,每天更新。
本文为 国外最新的AI资讯摘要与点评,非原文转载;版权归原作者所有,点击链接可读原文。
📚 往期回顾
- OpenAI Agents API 公测:Codex 底座直接调用,支持长周期…|AI落地与Agent
- Heurist Finance用Bedrock AgentCore建AI投资工…|AI落地与Agent
- HPE Zerto用Bedrock建本地化故障排查Agent|AI落地与Agent
- OpenAI内部AI研究实习生日均完成3.1人天工作量|AI落地与Agent
- OpenAI Astra让内部研发计划提前6个月,Agent真能拉快研发节奏|AI落地与Agent
- AWS上线多模态WhatsApp订餐Agent,支持语音+实时通话|AI落地与Agent
- Legora用GPT-6 Astra审41份财报文档,5分钟揪出全部4个错误|AI落地与Agent