OpenAI Agents API 公测:Codex 底座直接调用,支持长周期…|AI落地与Agent
有人把整套报关流程交给了 Agent,人只签字;今天 OpenAI 把这套能力打包成 API,开箱即用。
▍今日主打
OpenAI Agents API 公测:Codex 底座直接调用,支持长周期会话与自动工具调用
OpenAI 正式发布 Agents API 公共测试版,这不是一个新模型,而是一套‘Agent 运行时基础设施’:它将 Codex(即支撑 ChatGPT Pro 和内部高阶 Agent 的底层引擎)的能力封装为托管服务,支持长会话(long-running sessions)、自动工具调用、状态持久化与错误恢复。开发者只需传入系统提示词、工具定义和初始消息,OpenAI 即在沙盒中完成整个 Agent 生命周期管理——从首次响应到多轮决策、外部 API 调用、重试逻辑,全部无需自建调度器或状态机。
对想给公司做自动化的企业来说,这意味着:过去需要 2~3 周搭建的采购审批 Agent 或客服工单分派 Agent,现在可能 1 天内就能跑通 MVP;对开发者而言,它绕开了 LangChain/LlamaIndex 等框架中繁杂的状态同步、超时熔断、工具编排逻辑,让重心回归业务逻辑本身。尤其适合需要‘持续交互+多步骤动作’的场景,比如合同审核(读PDF→查法条→比条款→生成修订建议→发邮件),而非单次问答。
但要注意:它目前不开放私有模型接入,所有推理走 OpenAI 托管模型;企业敏感数据若需全程不出域,仍需自建方案。小团队建议先拿非核心流程(如会议纪要归档+日程同步)验证闭环,再迁移至采购/财务等关键链路。
—— 以下是今天的全部 15 条速览 ——
Agent 与流程自动化
1. OpenAI Agents API 公测:Codex 底座直接调用,支持长周期会话与自动工具调用
OpenAI 发布 Agents API 公共测试版,基于 Codex 引擎构建,提供托管式 Agent 运行环境;
支持 long-running sessions(最长 14 天)、内置工具调用、状态持久化与失败恢复机制;
开发者可将自有工具(如 CRM、ERP 接口)注册进 API,Agent 自动识别何时调用、如何传参、如何处理返回。
号哥说:这是首个由大厂推出的、真正面向生产级 Agent 部署的托管 API——不是模型,而是运行时。它把过去需自行实现的会话管理、工具路由、重试策略等‘脏活’全收走了,让企业能跳过工程基建阶段,直接聚焦业务逻辑封装。对比 LangGraph 等开源框架,省去至少 60% 的运维成本。
落地提点:别急着写 prompt,先把你公司最常重复、跨 3 个以上系统的流程(比如供应商准入)拆成 5 步,这就是 Agents API 最该干的第一件事。
OpenAI News · 阅读原文
2. AWS AgentCore 助 AvioBook 实现航班周转分析自动化:运营数据秒变可执行洞察
AvioBook(Thales 子公司)使用 Amazon Bedrock AgentCore 构建 Connected Analytics,连接其 AvioBook Connect 系统;
Agent 可直接解析航班延误日志、地勤操作记录、天气数据等多源结构化/半结构化数据;
向空管调度员和机场经理提供自然语言问答,例如‘昨天成都双流 T2 延误超 30 分钟的前 3 个根本原因是什么?’并附证据截图。
号哥说:这不是 RAG 查文档,而是让 Agent 直接‘看懂’航空业专有数据流,并在分钟级内给出带归因的行动建议。其关键在于 AgentCore 对 AWS 内部数据源(如 S3、Redshift)的原生集成能力,省去了 ETL 和 schema 映射环节——制造业、物流业可直接复用此模式做设备故障根因分析。
落地提点:航空业已用上,你的工厂 MES 或 WMS 数据,其实也早该喂给 Agent 做实时诊断了,别卡在‘等数据治理完’。
AWS Machine Learning Blog · 阅读原文
3. AWS 发布 Agent Evaluation Metric(AEM):专治多轮对话中‘一步错、步步错’的评估盲区
传统单轮评估无法发现 Agent 在 multi-turn 对话中的累积性错误,例如第 2 轮误解用户意图导致后续全错;
AEM 是首个可分解的 turn-level 评估指标,能定位具体哪一轮出错、错误类型(事实性/逻辑性/工具调用);
已在 Bedrock AgentCore 上实测,帮助客户将 Agent 任务成功率从 68% 提升至 89%,主要靠修复早期意图识别偏差。
号哥说:这是 Agent 落地最关键的‘质量仪表盘’:没有 AEM,企业只能靠人工抽检,效率低且难归因;有了它,就能像监控服务器 CPU 一样监控 Agent 的每一轮决策健康度。尤其适合金融、法律等容错率极低的行业做上线前压测。
落地提点:上线前不跑 AEM 评估的 Agent,等于没做压力测试——别让老板第一次用就遇到‘它明明听懂了却办错事’的尴尬。
AWS Machine Learning Blog · 阅读原文
4. LandingAI 发布 Agentic Document Extraction Gen2:用 DPT-3 Pro/Verity 实现像素级文档理解
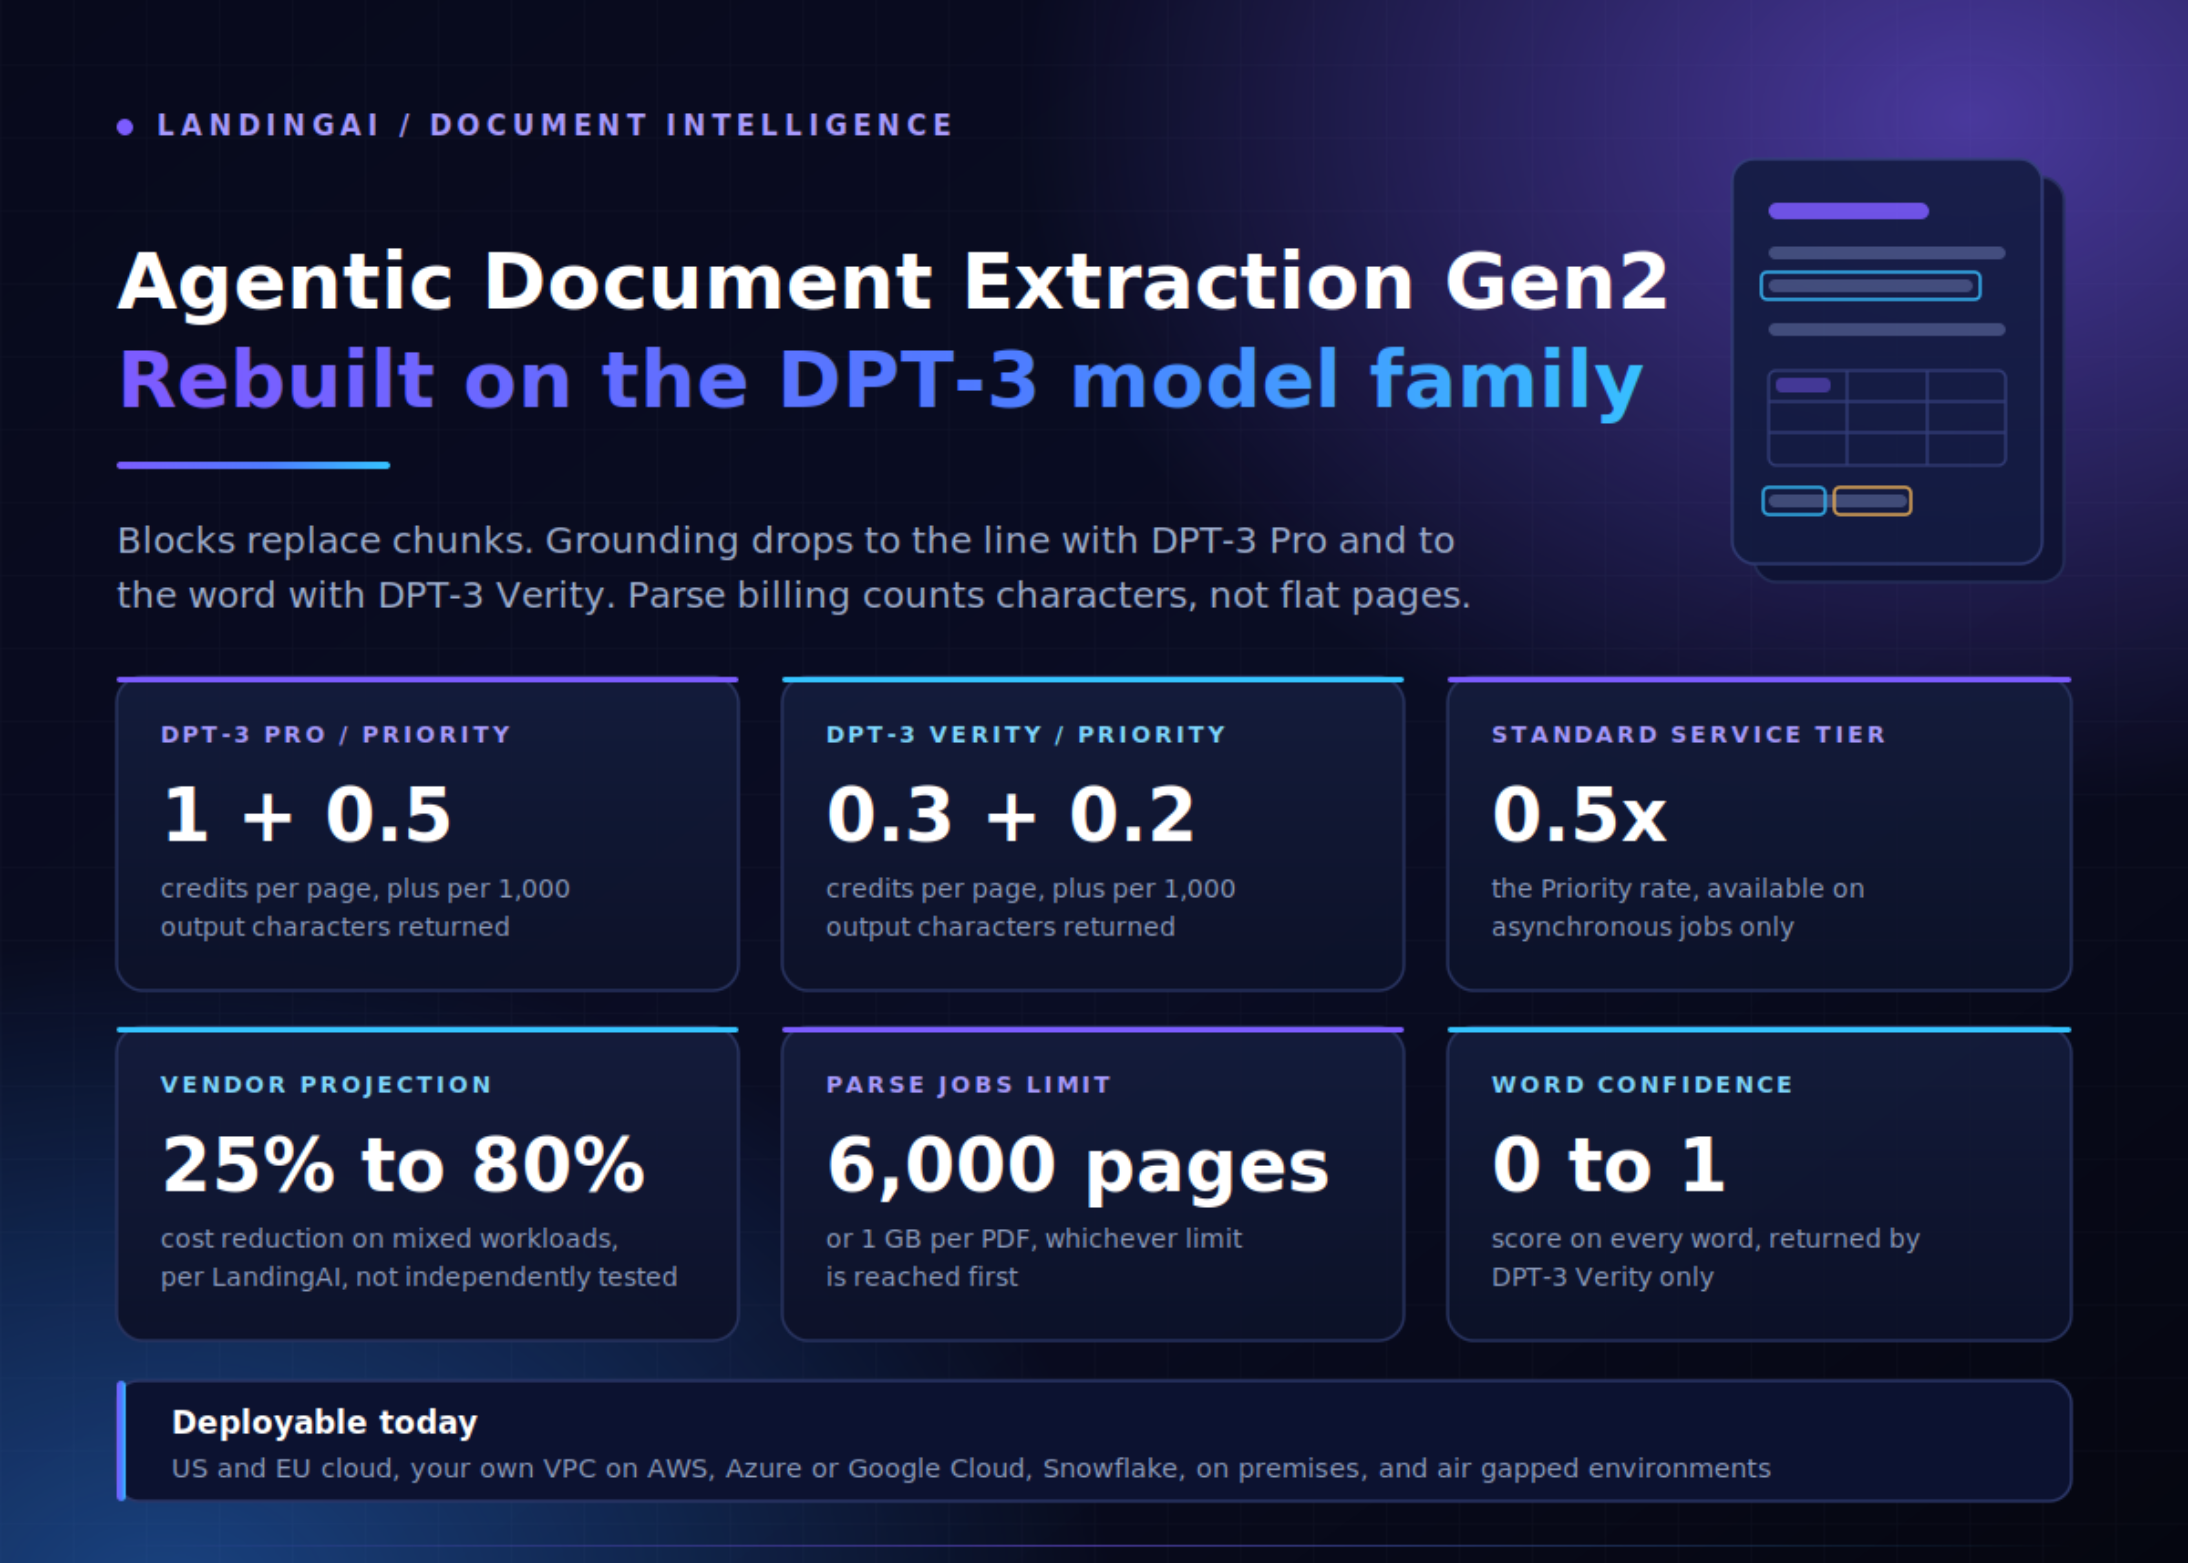
Agentic Document Extraction Gen2 彻底抛弃传统‘按页切块’逻辑,改为构建文档-页面-区块三级树状结构;
DPT-3 Pro 支持行级定位,DPT-3 Verity 支持字级定位+置信度打分,适用于发票、合同、医疗报告等高精度场景;
计费模式从‘按页’改为‘按输出字符’,客户平均成本下降 40%,同时提取准确率提升至 99.2%(在 EU e-Invoice 标准测试集)。
号哥说:文档智能正从‘OCR+关键词匹配’进入‘Agent 式理解’阶段:Gen2 不是静态提取,而是让模型像人一样逐层解析文档语义结构,并主动判断哪些字段需要交叉验证(如金额与税码是否匹配)。这对财务共享中心、保险理赔等强规则场景是降本提效的关键杠杆。
落地提点:还在用 OCR+正则?你的发票审核流程,已经落后于 LandingAI 新版 Agent 两个代际了。
MarkTechPost · 阅读原文
5. AWS 推出模型无关 PII 检测方案:用 LLM Prompt 即可适配任意新敏感实体类型
该方案不依赖预训练模型或固定规则库,仅通过自然语言 prompt 描述待检测实体(如‘欧盟 GDPR 定义的生物识别数据’);
在 5 个公开 PII 数据集上 F1 达 92.7%,超越 spaCy、Presidio 等专用工具;
可直接部署在 Amazon Bedrock 上任意基础模型(Claude、Llama、Cohere)之上,无需微调或重训练。
号哥说:这是企业数据安全合规落地的重大简化:过去每新增一类敏感数据(如‘中国个保法下的未成年人信息’),IT 部门需数周开发新规则或重训模型;现在法务写一段中文描述,开发 1 小时内即可上线检测。特别适合跨国企业应对多国隐私法规快速迭代。
落地提点:别再堆 PII 工具了,用这个方案,让法务同事自己写 prompt 就能管住新出的监管要求。
AWS Machine Learning Blog · 阅读原文
AI 工具 · 实测上新
1. Redis LangCache 正式发布:语义缓存服务,LLM API 成本直降 90%
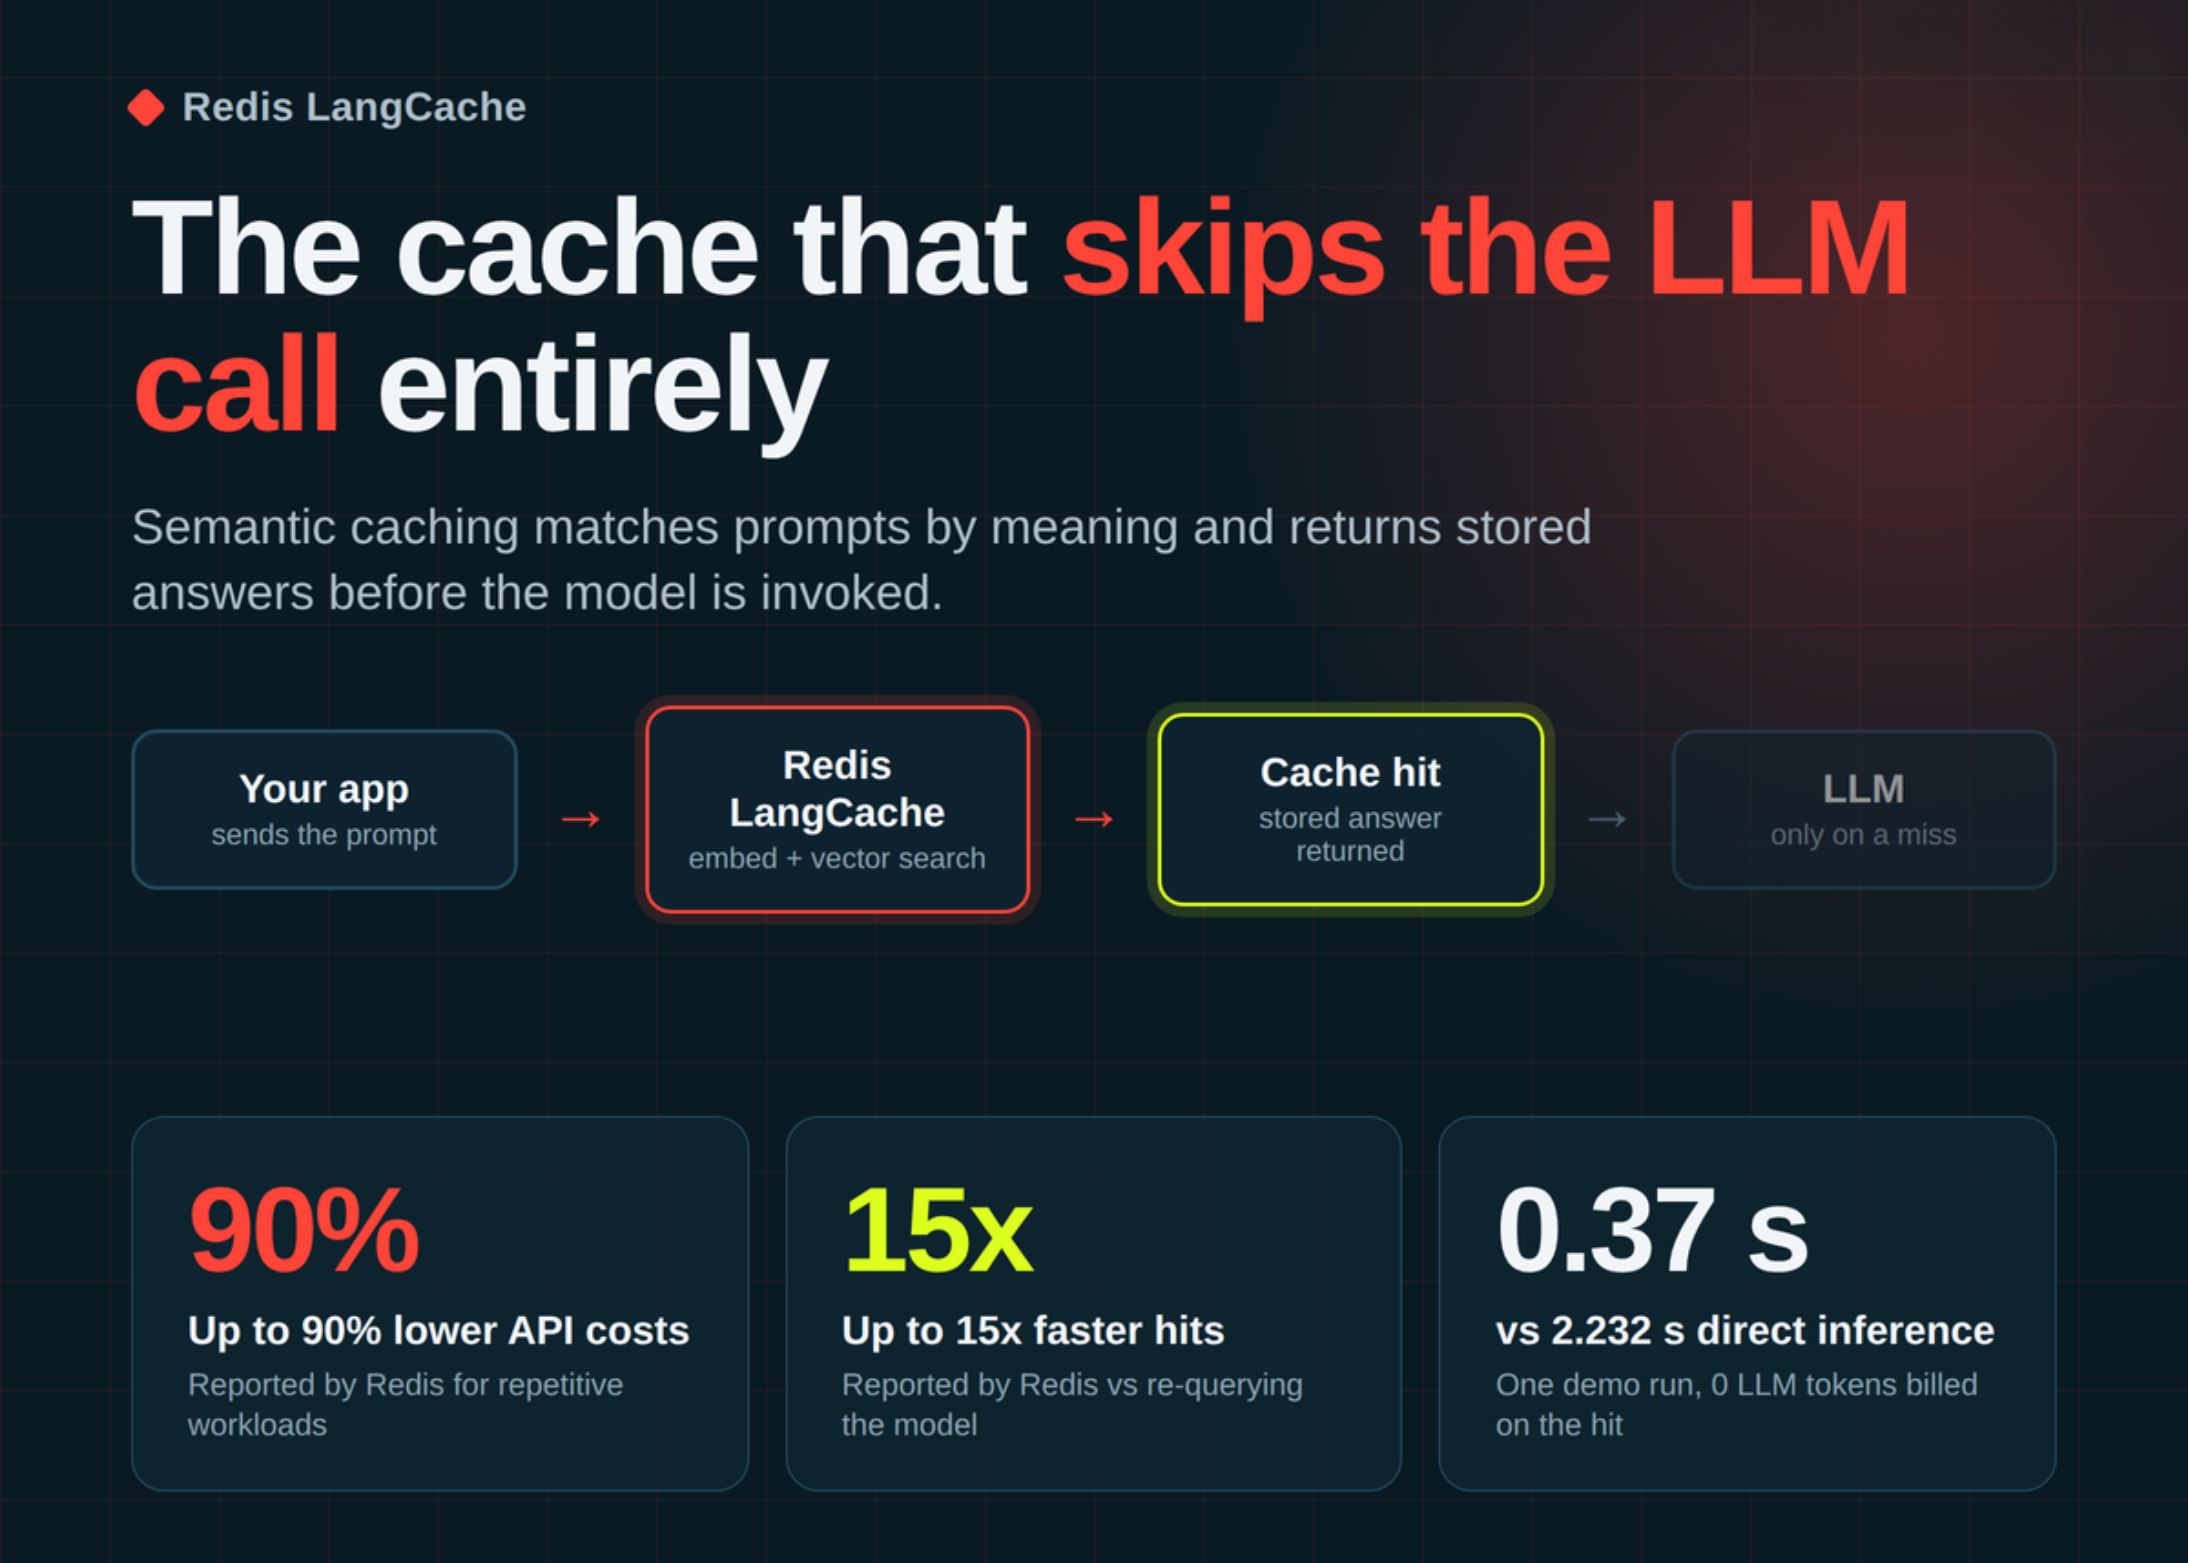
Redis LangCache 是首个完全托管的语义缓存服务,自动将相似语义问题映射到同一缓存键;
支持主流 LLM API(OpenAI、Anthropic、Cohere),无需修改应用代码,仅需替换 endpoint;
在客服场景实测:相同问题不同问法(如‘怎么退款’‘我要退钱’‘订单取消后钱啥时候到’)命中同一缓存,P95 延迟从 2.1s 降至 140ms。
号哥说:它解决的是 LLM 应用最痛的成本黑洞——大量重复意图被当成全新请求计费。与传统 Redis 缓存不同,LangCache 能理解‘换种说法但意思一样’,且自动处理 embedding 向量更新、缓存淘汰策略,连向量数据库都省了。中小团队上线成本近乎为零。
落地提点:只要你的 LLM 应用有高频重复问题(客服/HR/IT 支持),装 LangCache 就是 ROI 最高的第一步,比换模型还快见效。
MarkTechPost · 阅读原文
2. Amazon Quick Automate 上线端到端 RFI 问卷工作流:S3 文档解析 → NL 提取 → CSV 输出,开发耗时从天级降至小时级
Quick Automate 可直接读取 S3 中多标签 Excel RFI 问卷,用自然语言指令提取‘技术参数’‘交付周期’‘质保条款’等字段;
支持对话式调试:用户反馈‘漏了第 3 页的验收标准’,系统自动修正 prompt 并重跑;
最终生成结构化 CSV 写回 S3,供采购系统自动比价,全流程无需写一行代码。
号哥说:RFI(信息征询)是采购/招标中最耗人力的环节之一,传统方式需人工复制粘贴 10+ 供应商文档。Quick Automate 将其变成‘上传→提问→下载’三步操作,且保留完整审计链(谁改了哪条 prompt、哪次运行结果)。对国企、制造业采购部门极具实操价值。
落地提点:采购总监别再催 IT 开发 RFI 工具了,今天就用 Quick Automate 把上季度 20 份 RFI 补跑一遍,效果立见。
AWS Machine Learning Blog · 阅读原文
3. DeepSeek-V4.1-Flash 正式发布:552B 参数 multimodal 模型,KV 缓存内存降至 1/4
V4.1-Flash 是 DeepSeek 最新 multimodal MoE 模型,含 552B 主干参数 + 196B Engram 参数,支持 1M token 上下文;
采用 FP4 KV cache 与 cross-layer attention reuse 技术,显存占用仅为前代 V4 的 25%;
在 DeepSWE 编程基准上得分超越 GPT-Astra,推理吞吐达 128 tokens/sec(A100 80GB)。
号哥说:它专为 Agent 场景优化:长上下文+低显存=更长的自主思考链(chain-of-thought)和更低的硬件门槛。中小团队用单张 A100 就能跑起支持复杂工具调用的 Agent,不再被显存墙卡死。但注意:多模态能力目前仅限图文,暂不支持视频帧。
落地提点:想本地部署 Agent 又卡在显存?V4.1-Flash 是当前性价比最高的选择,尤其适合需要百万 token 上下文的法律/金融文档 Agent。
The Decoder · 阅读原文
4. Amazon SageMaker HyperPod 新增模型缓存:冷启动从数十分钟压缩至秒级
HyperPod 现支持模型权重与容器镜像预加载至节点本地 NVMe 存储,避免每次推理都网络拉取;
实测 Llama 3.1 70B 模型冷启动时间从 22 分钟降至 3.7 秒,集群资源利用率提升 35%;
配置只需在 SageMaker SDK 中启用 cache_policy 参数,无需修改模型代码或容器。
号哥说:这是大模型推理服务化的关键一跃:过去企业不敢用大模型做实时服务,主因是冷启动不可控。现在 HyperPod 让它像普通微服务一样稳定启停,特别适合需要突发扩容的 Agent 场景(如电商大促期间客服 Agent 浪涌)。
落地提点:如果你的 Agent 经常‘第一句话慢得像在思考人生’,HyperPod 模型缓存就是最快的止痛药,改一行配置就能上线。
AWS Machine Learning Blog · 阅读原文
5. Amazon SageMaker Inference 推出前缀感知路由:KV 缓存命中率从 25% 提升至 80%+
新功能 prefix-aware routing 将相同 prompt 前缀的请求路由至同一实例,保持 KV cache 温热;
在 Llama 3.1 70B 实测中,P50 首 token 延迟降低 77%,P95 延迟降低 63%;
对 Agent 场景尤为关键——多轮对话中用户反复追问同一主题(如‘继续分析刚才的财报’),缓存复用率大幅提升。
号哥说:它直击 Agent 性能瓶颈:多轮对话中,每次用户说‘继续’,传统路由会让请求随机落到不同实例,导致每次都重算 KV cache。prefix-aware routing 让 Agent 像人类一样‘记住上下文’,是提升用户体验最务实的技术升级。
落地提点:Agent 响应慢?先开 prefix-aware routing,比换 GPU 更快见效——尤其适合对话式客服、投顾等强交互场景。
AWS Machine Learning Blog · 阅读原文
行业 AI 落地
1. Pocket FM:印度音频平台用 AI 生产 93% 内容,制作成本降为原来的 1/80

Pocket FM 利用自研 AI 工具链生成 99% 新上线音频内容(广播剧、有声书),覆盖 12 种印度方言;
单集制作成本从人工 800 美元降至 AI 10 美元,内容上线周期从 2 周压缩至 4 小时;
用户收听时长增长 3.2 倍,付费转化率提升 27%,验证 AI 内容具备真实商业价值。
号哥说:这不是玩具 Demo,而是已跑通的盈利模型:AI 不是替代编剧,而是将创意人员从‘录音-剪辑-混音’中解放,专注故事架构与角色设计。对国内有声书、知识付费、本地生活音频平台而言,其工具链组合(TTS+剧情生成+方言适配)可直接借鉴。
落地提点:你的知识付费课程还在找配音?Pocket FM 的路径证明:AI 音频不是降质,而是用 1/80 成本打开 10 倍用户规模。
TechCrunch AI · 阅读原文
2. NVIDIA 与 Palantir 合作打造 AI 供应链中枢:先接管 NVIDIA 自身百万级零部件调度
双方联合开发 AI 供应链平台,融合 Palantir Foundry 数据操作系统与 NVIDIA 的 BioNeMo、Omniverse 数字孪生能力;
首期落地 NVIDIA 全球供应链,实时追踪 120 万种零部件库存、物流、产能约束,并自动触发补货/切换供应商决策;
试点 3 个月后,缺货预警准确率提升至 94%,紧急空运成本下降 31%。
号哥说:这是工业级 AI Agent 的标杆案例:不是单点优化,而是将采购、生产、物流、仓储全链路数据打通,让 Agent 基于实时约束自主决策。对中国制造企业而言,其价值不在‘炫技’,而在解决‘芯片断供’‘海运延误’等真实生存问题。
落地提点:别再说‘我们供应链太复杂 AI 搞不定’——连 NVIDIA 百万零件都能管,你产线的 BOM 表和 ERP 数据,就是 Agent 最该吃的头道菜。
The Decoder · 阅读原文
3. Slack 推出 Slackforce Surfaces:聊天框内 AI 生成交互式图表与微站

新功能允许用户在 Slack 中对 Slackbot 描述需求(如‘展示 Q3 各区域销售额对比’),AI 自动从 Google Sheets/Salesforce 拉取数据并生成可筛选图表;
支持一键发布为微站(microsite),嵌入网页或邮件,权限可控;
实测销售团队用该功能将周报制作时间从 5 小时缩短至 12 分钟,且数据实时联动源系统。
号哥说:这标志着企业协作工具正式进入‘AI 原生’阶段:数据不再需要导出-加工-导入,而是在协作流中实时生成可操作洞察。对市场、销售、运营等强数据驱动岗位,它让‘会提问’成为新生产力核心。
落地提点:你的日报还在 copy-paste Excel?Slackforce Surfaces 证明:最好的 BI 工具,已经藏在你每天打开最多的聊天框里。
The Verge AI · 阅读原文
4. Universal Music 与 ElevenLabs 推出 AI 音乐平台:授权曲库驱动安全 Remix 与创作

平台允许用户基于 UMG 数百万首授权曲目进行 AI Remix、风格迁移、人声替换,所有输出受版权水印与使用许可管控;
ElevenLabs 提供语音克隆与音乐生成模型,UMG 提供曲库+版权清算能力,规避法律风险;
首批面向创作者开放,未来将嵌入 Spotify、Apple Music 等流媒体平台。
号哥说:这是内容产业 AI 化的破冰之举:既释放创作者潜力,又守住版权底线。对国内 MCN、音乐平台、教育机构而言,其‘授权数据+可控生成+合规分发’三角模型,比纯开源模型更具落地参考价值。
落地提点:别再纠结‘AI 会不会搞垮音乐人’——UMG 的做法告诉你:把版权当基建,AI 才是放大创意的新喇叭。
The Verge AI · 阅读原文
5. Meta Muse 在 WhatsApp 上实现全链路商务代理:比价、下单、议价、售后全托管
Muse 可接入用户 WhatsApp 账户,在聊天中自动完成商品比价、下单支付、价格协商(如向商家发送‘同款能否 8 折?’)、物流追踪、退货申请;
已支持 17 国电商网站及本地零售商,议价成功率超 63%(基于 200 万次真实对话统计);
用户无需跳转 App,全程在 WhatsApp 内完成,会话数据端到端加密,不上传 Meta 服务器。
号哥说:这是消费领域 Agent 落地最成熟的案例:它不追求‘全能’,而是死磕购物决策链中最耗神的 3 个环节——比价、砍价、售后。对跨境电商、本地生活服务平台而言,Muse 的 WhatsApp 集成路径(轻安装、高触达、强信任)值得直接抄作业。
落地提点:你的小程序还在弹窗求授权?Muse 证明:用户最愿意交出购物权的地方,是那个天天聊家常的 WhatsApp 对话框。
The Decoder · 阅读原文
———— 关于我们 ————
「号哥聊AI」专注 AI 落地:帮企业把重复、跨系统的流程做成 AI Agent(采购、客服、单据、报表……)。
· 想让公司某个流程自动化 —— 在本号【发消息回复「自动化」】,我们帮你看看能怎么落地;
· 想学 Agent 开发 / AI 工具 —— 关注本号,每天更新。
本文为 国外最新的AI资讯摘要与点评,非原文转载;版权归原作者所有,点击链接可读原文。
📚 往期回顾
- Heurist Finance用Bedrock AgentCore建AI投资工…|AI落地与Agent
- HPE Zerto用Bedrock建本地化故障排查Agent|AI落地与Agent
- OpenAI内部AI研究实习生日均完成3.1人天工作量|AI落地与Agent
- OpenAI Astra让内部研发计划提前6个月,Agent真能拉快研发节奏|AI落地与Agent
- AWS上线多模态WhatsApp订餐Agent,支持语音+实时通话|AI落地与Agent
- Legora用GPT-6 Astra审41份财报文档,5分钟揪出全部4个错误|AI落地与Agent
- AWS AgentCore 实现 .NET 代码自动转架构图与可搜索文档|AI落地与Agent